Le dimos a cada blockchain su propio agente de guardia
Autor: Sam Raghunath
Cómo Alchemy usa más de 230 agentes para hacer triage y corregir alertas en nuestra flota de nodos
Alchemy opera la infraestructura de más de 230 redes blockchain y administra miles de servidores que procesan más de $1T en transacciones cada año. Nuestro negocio es mantener cada nodo saludable y sincronizado, para que las aplicaciones que dependen de él sigan funcionando.
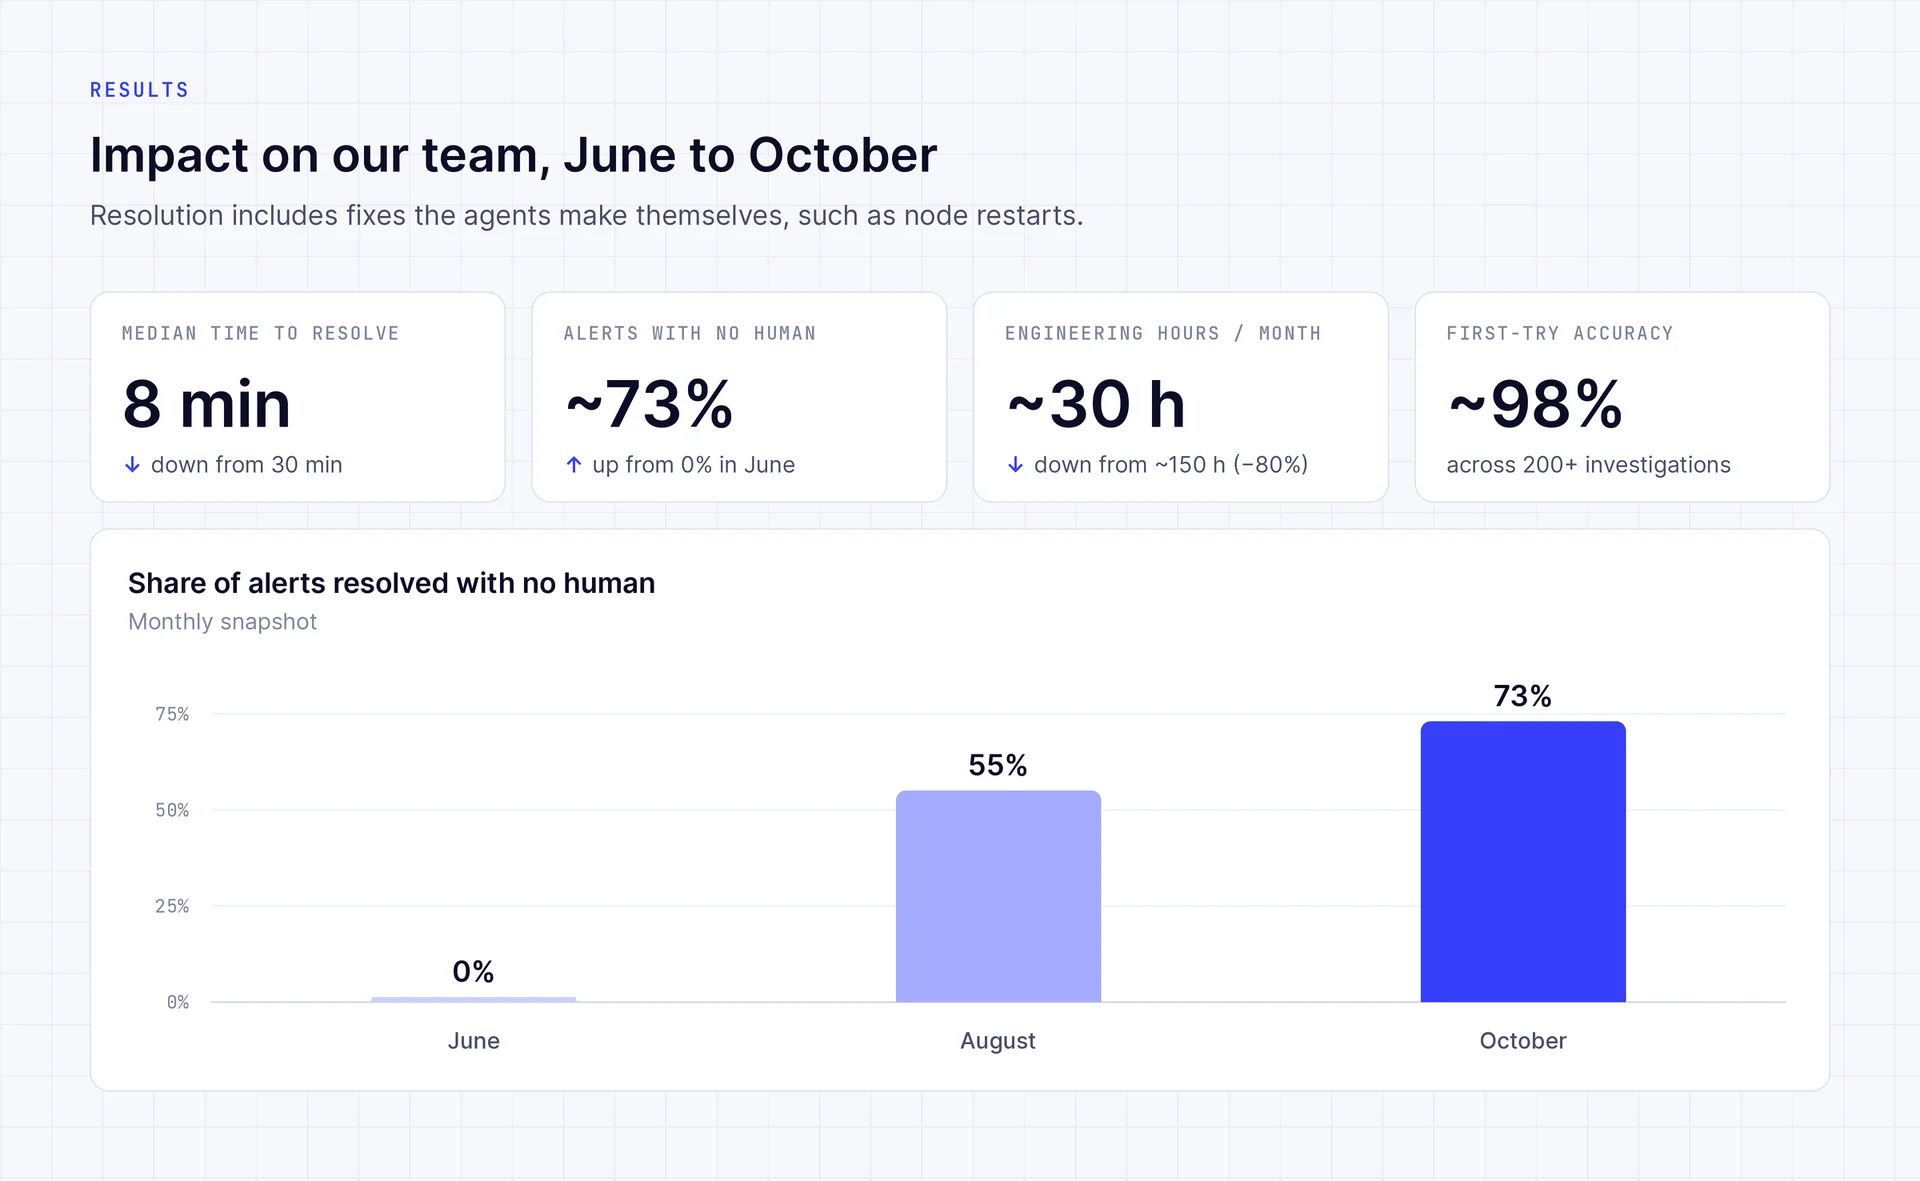
En los últimos cuatro meses construimos una fábrica de agentes que administra más de 230 agentes distintos, uno por cada red blockchain, para investigar y resolver incidentes. La mediana del tiempo de resolución de una alerta ahora es de 8 minutos, frente a 30 minutos cuando la resolvía una persona. Los agentes resuelven cerca del 73% de las alertas sin intervención humana, y cerca de 120 horas de ingeniería al mes ahora se dedican a trabajo más productivo en lugar de diagnosticar y corregir problemas.
El problema: 500 alertas por semana en una infraestructura diversa
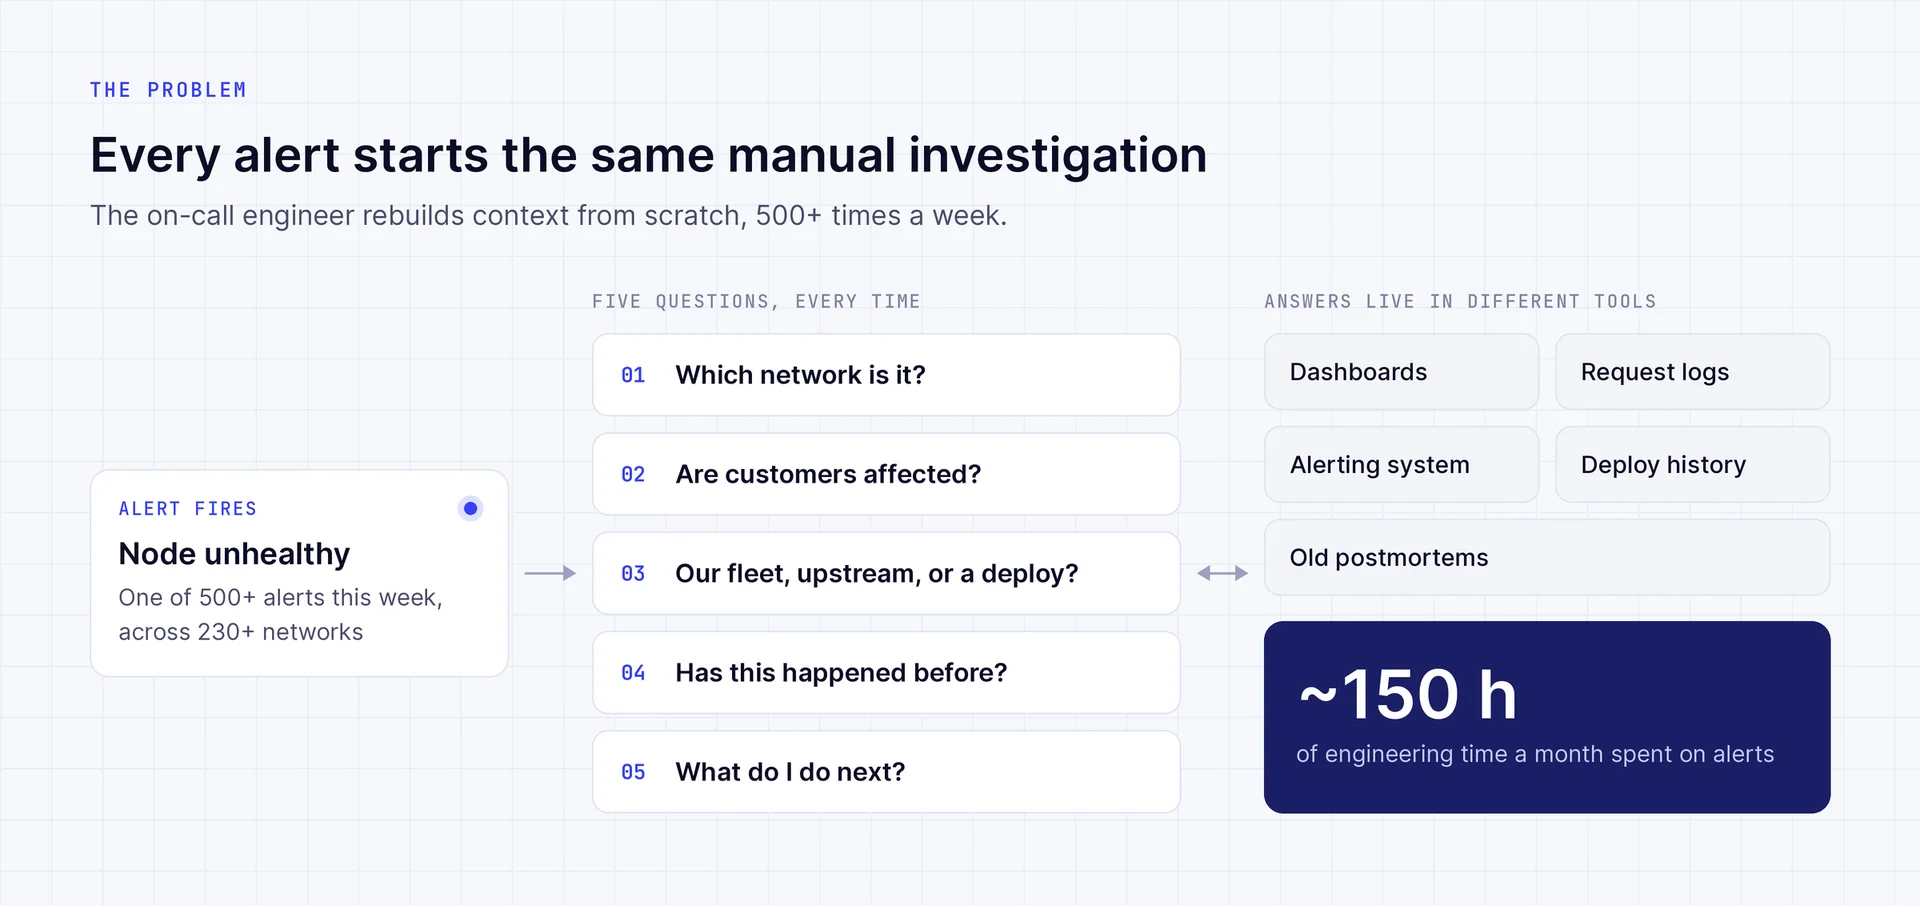
Nuestra flota de nodos genera más de 500 alertas por semana para nuestro equipo de Node Ops. Como en cualquier equipo de ingeniería de software, el ingeniero de guardia lleva cada alerta por la misma investigación de cinco preguntas:
- ¿Qué red es?
- ¿Hay clientes afectados?
- ¿El problema está en nuestra flota o upstream, en la propia red? ¿Tal vez un deploy?
- ¿Esto ya pasó antes?
- ¿Qué hago ahora?
Las respuestas están repartidas entre dashboards, logs de solicitudes, el sistema de alertas, el historial de deploys y postmortems antiguos. Multiplica eso por 500 alertas y por las particularidades de cada red, y una cantidad significativa de tiempo se va en reconstruir contexto y remediar problemas en lugar de eliminar sus causas.
La regla de diseño: optimizar para la decisión
Un agente con acceso a todas las herramientas las leerá todas sin problema. Eso produce un reporte largo que el ingeniero todavía tiene que revisar a fondo. El ingeniero no necesita más datos. Necesita una decisión: ¿esta alerta necesita a una persona, y con qué urgencia?
Por eso tenemos una sola regla: optimizar para la decisión.
Cómo funciona
1. Determinar el impacto antes de interrumpir a una persona
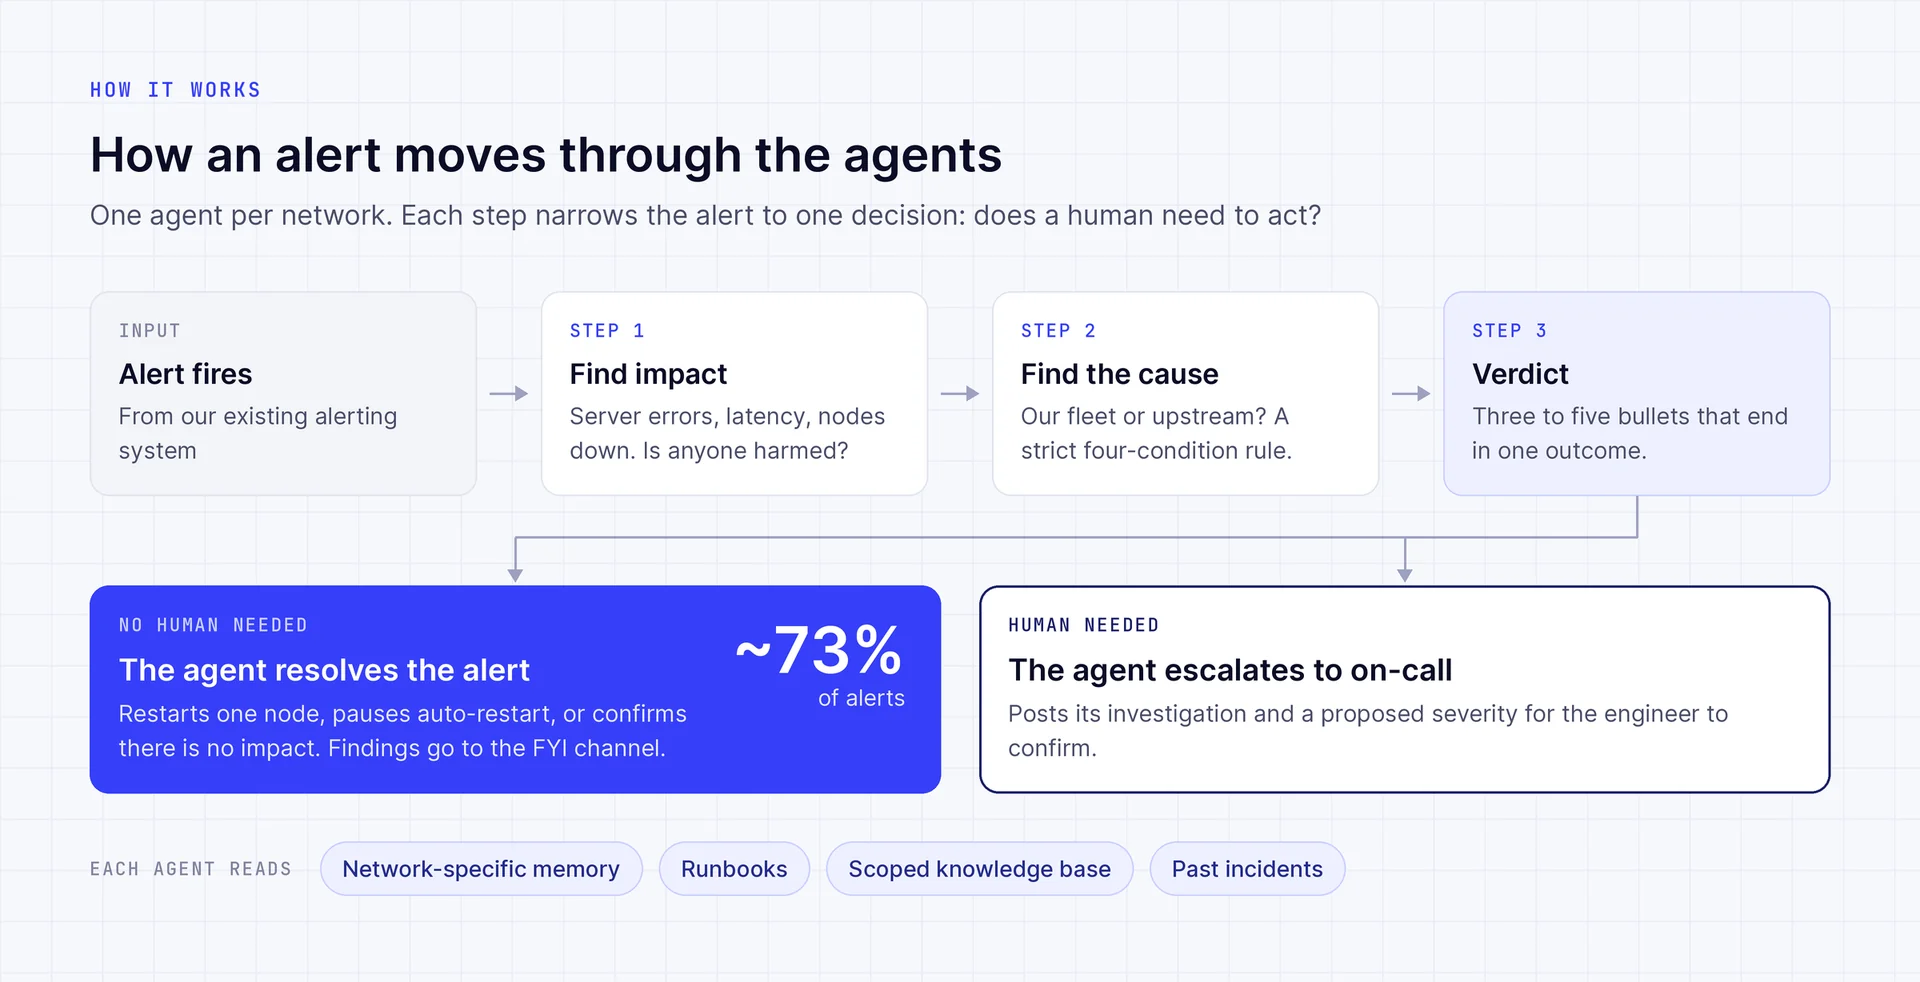
Nuestro sistema de alertas ya detecta problemas, más de 500 veces por semana. Los agentes no necesitan detectarlos otra vez. Su trabajo es decidir si a alguien le debe importar.
Una alerta disparada no es automáticamente un incidente. Una alerta se convierte en incidente solo cuando el agente encuentra evidencia de daño real, como errores de servidor visibles para los clientes, un aumento importante de la latencia o todos los nodos de una flota caídos.
Si el agente no encuentra daño, publica sus hallazgos en un canal "FYI" separado. Solo los incidentes reales llegan al canal de guardia.
2. Investigaciones con un veredicto
El agente publica de tres a cinco viñetas que terminan en uno de dos resultados. Si no se necesita a una persona, el agente resuelve la alerta por sí mismo. Si se necesita a una persona, publica su investigación más detallada en el canal de guardia.
Cinco ejemplos reales:
El ingeniero lee primero el resultado y después la evidencia, si es que la lee.
3. Actuar dentro de límites que impone el código
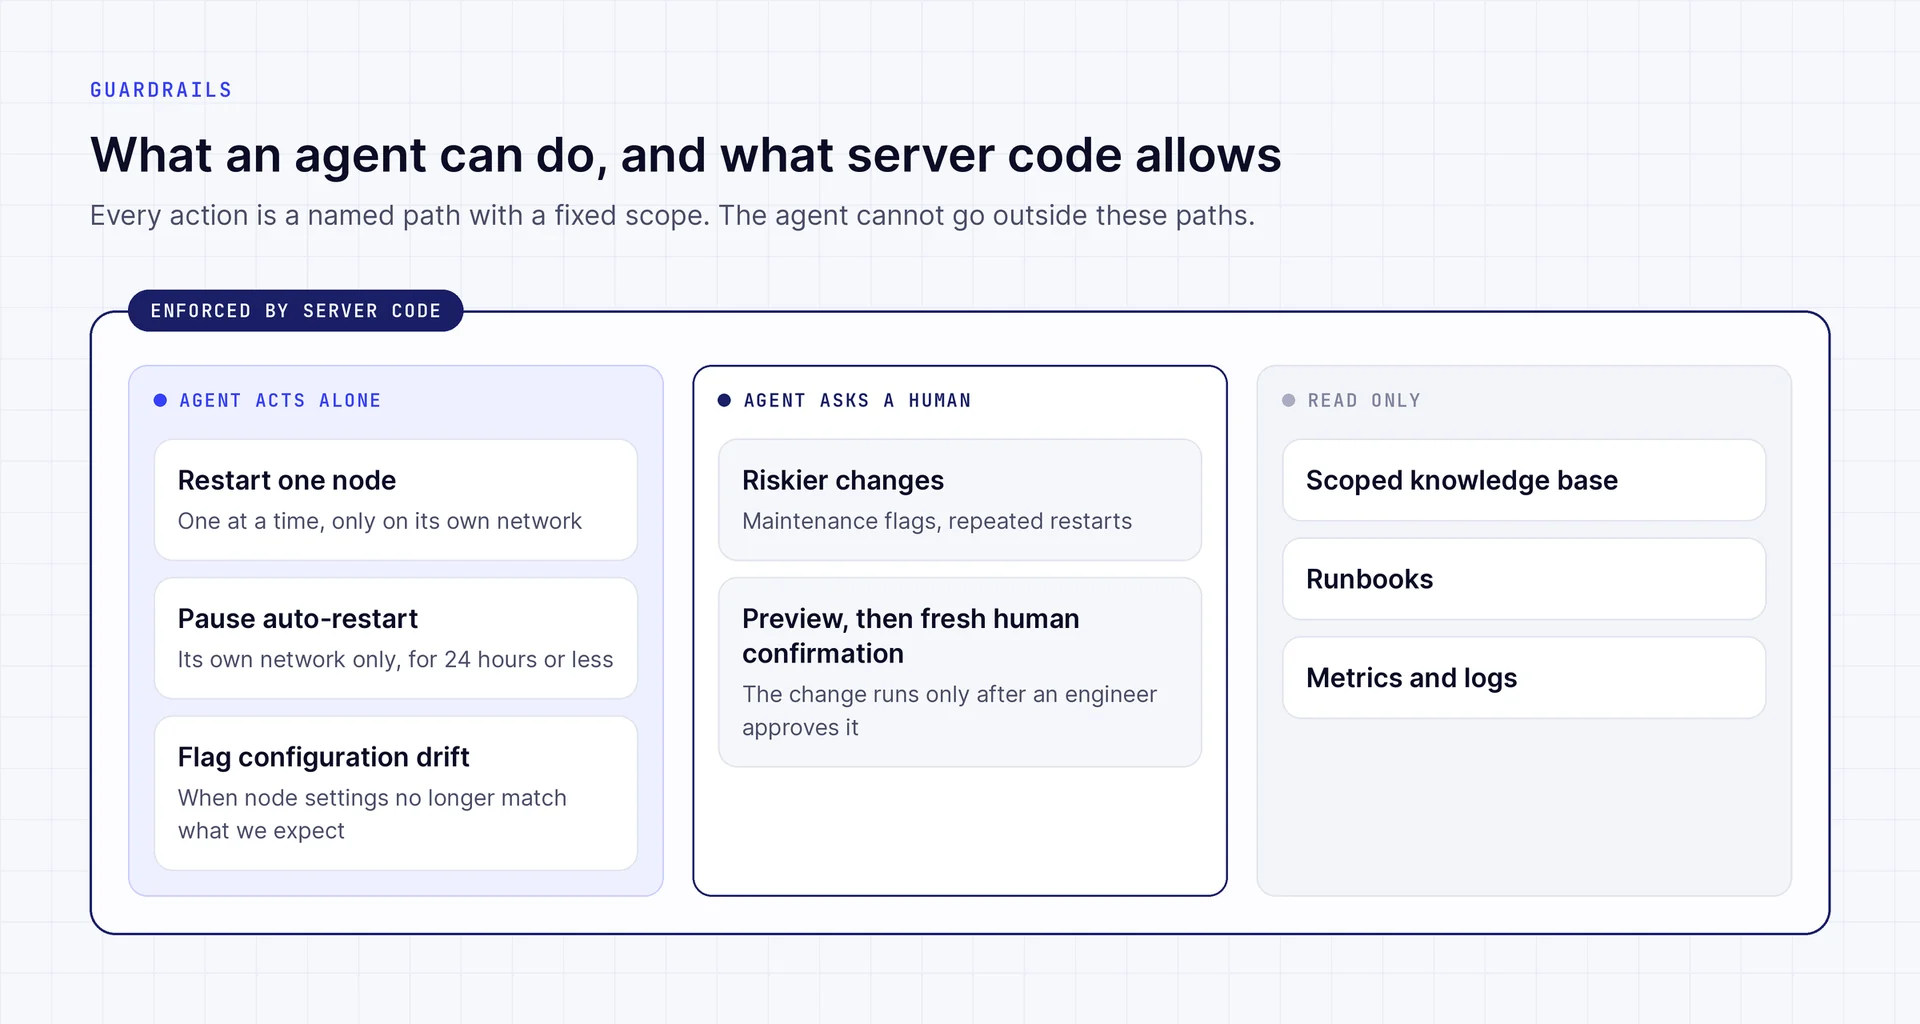
Como se vio arriba, la resolución a menudo ocurre sin una persona. Les dimos a los agentes la capacidad de reiniciar nodos no saludables para restaurar el servicio, y de señalar desviaciones de configuración cuando los ajustes de un nodo ya no coinciden con lo que esperamos.
Cada acción tiene un alcance limitado, y el código del servidor lo impone. Un agente puede:
- Reiniciar exactamente un nodo de una red a la vez, para que no pueda retirar demasiada capacidad de una sola vez.
- Pausar nuestro sistema de reinicio automático para su propia red, por un máximo de 24 horas, para evitar la corrupción de datos.
- Pedir a una persona. Los cambios más riesgosos, como las marcas de mantenimiento o los reinicios repetidos, necesitan una vista previa y luego una nueva confirmación humana.
Fuera de esas rutas, los agentes solo leen datos de sus bases de conocimiento y playbooks con alcance definido. Limitar el acceso de los agentes es lo esencial cuando les permites interactuar con infraestructura de producción en vivo.
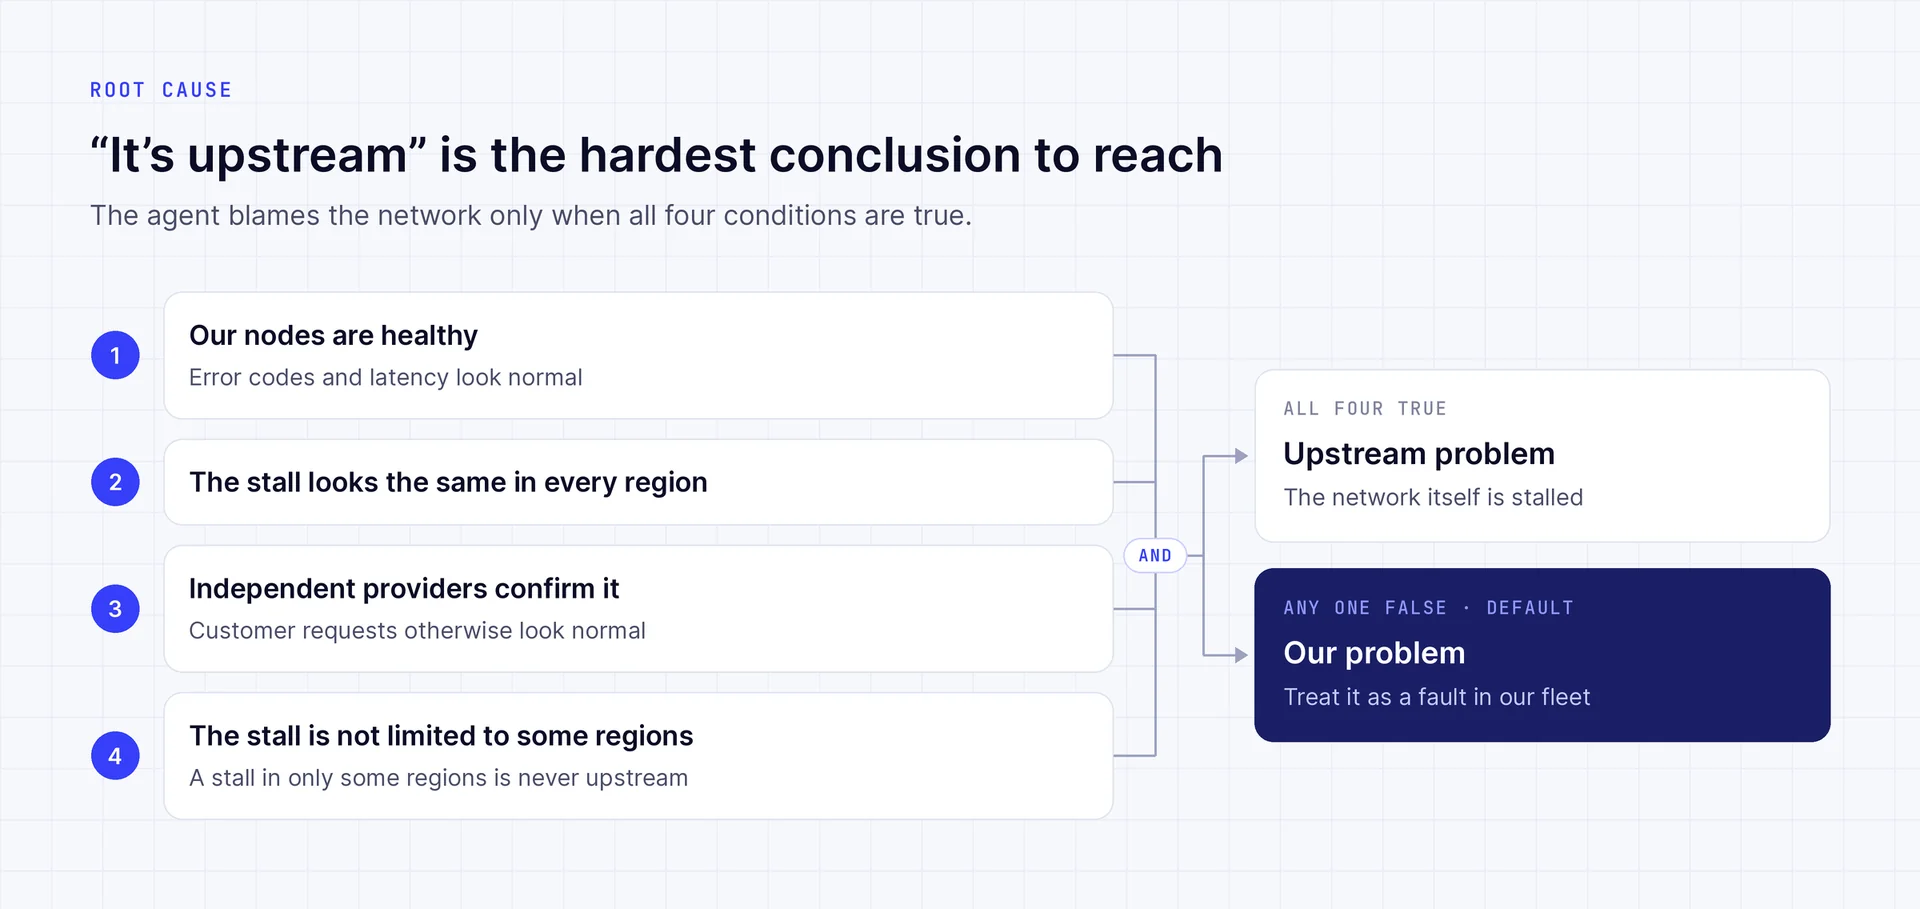
4. Hacer de "es upstream" la conclusión más difícil
La parte divertida (o al menos a nosotros nos parece divertida) de operar nodos blockchain es que son poco confiables por naturaleza. Los clientes pueden tener problemas, no todas las redes se comportan igual bajo distintas cargas de trabajo, y los operadores de red upstream (validadores, secuenciadores, etc.) pueden hacer que nuestra infraestructura se detenga o falle. Por eso cada agente necesita memoria e instrucciones específicas de su red, y las necesita para responder una pregunta: "¿Somos nosotros o son ellos?"
Un agente debe cumplir cuatro condiciones antes de decir "upstream":
- Nuestros nodos deben estar saludables, desde el punto de vista de la tasa de errores y la latencia.
- Los errores upstream (por ejemplo, una "detención" de la red) deben verse iguales en todas las regiones donde operamos.
- Proveedores independientes deben confirmarlo, y las solicitudes de los clientes deben verse normales en todo lo demás.
- Una detención solo en algunas regiones nunca es upstream.
La regla funciona en ambas direcciones. En una alerta, seis nodos no estaban saludables, pero la red seguía produciendo bloques nuevos. El agente lo clasificó como un problema de nuestro servicio, no como una detención upstream.
Resultados: mayor confiabilidad, resolución más rápida
Gracias a estas inversiones, las horas de ingeniería se dedican a trabajo significativo, y nuestros clientes obtienen una resolución más rápida de los problemas en cualquier red sobre la que construyan.
- Las alertas se resuelven casi cuatro veces más rápido. La mediana del tiempo de resolución bajó de 30 minutos a 8.
- La mayoría de las alertas nunca necesitan a un ingeniero. El agente resuelve por sí mismo cerca del 73% de las alertas, frente al 0% en junio.
- El equipo recuperó cerca de 120 horas al mes. El tiempo de ingeniería dedicado a alertas bajó de cerca de 150 horas al mes a cerca de 30, una reducción del 80%. Eso equivale a cerca de tres semanas de ingeniero cada mes que ahora se dedican a eliminar causas en lugar de reconstruir contexto.
- El agente acierta a la primera. En más de 200 investigaciones del último mes, la precisión de la causa raíz en el primer intento fue de cerca del 98%.
Lo que le diríamos a un equipo que construye su propio agente de guardia
- Mide resultados. Evalúa un agente de guardia por el tiempo de resolución, la precisión y las horas de ingeniería ahorradas.
- Exige un veredicto. Un agente que devuelve una página de hallazgos movió el trabajo, no lo eliminó. Exígele que empiece con una decisión: resolver la alerta, o llamar a una persona e indicar con qué urgencia.
- Otorga acciones con nombre y alcance fijo. Un reinicio de un solo nodo con un límite de 24 horas es más seguro que el acceso directo a una shell.
- Dale a cada agente un área limitada y una memoria larga. Un agente por red, con los runbooks, las particularidades y el historial de incidentes de esa red, no tiene que redescubrir tu sistema en cada alerta. Ya sabe que esta es la séptima detención del día.
Pero lo más importante: no te detengas en la investigación de problemas. Un agente que puede evitar que los problemas lleguen a una persona multiplica el esfuerzo de ingeniería que dedicas a generar valor para los clientes.
¿Te interesa este tipo de cruce entre IA aplicada e infraestructura?
- Sigue a @onewaysidewalks para mantenerte al día sobre todo lo relacionado con IA en Alchemy.
- Únete al equipo. ¡Estamos contratando!
Boletín de Alchemy
Entérate primero de los lanzamientos
Suscríbete a nuestro boletín
Recibe las últimas actualizaciones de productos y recursos de Alchemy
Al ingresar tu correo electrónico, aceptas recibir nuestras comunicaciones de marketing y actualizaciones de productos. Reconoces que Alchemy procesa la información que recibimos de acuerdo con nuestro Aviso de Privacidad. Puedes cancelar tu suscripción en cualquier momento.
Artículos relacionados
Glamsterdam: la guía completa para desarrolladores de Ethereum
Glamsterdam ya está en Sepolia. La guía completa sobre lo que significa para los desarrolladores y cómo Alchemy se preparó para la actualización de la red.
¿Con qué proveedor de RPC deberías construir en Tokio?
Comparamos cinco de los proveedores de RPC que sirven Tokio en cinco cadenas. Así se comparan, y dónde importan las diferencias para los equipos sensibles a la latencia.
Diseño de lecturas RPC de Solana para velocidad y confiabilidad líderes en la industria
Alchemy tiene la latencia de lectura de Solana más baja: 9.21 ms, cerca de 26% más rápido que el siguiente proveedor.