すべてのブロックチェーンに専用のオンコールエージェントを配置した
著者: Sam Raghunath
Alchemyが230以上のエージェントでノードフリート全体のアラートをトリアージし修正する方法
Alchemyは230以上のブロックチェーンネットワークのインフラを運用しており、年間1兆ドル以上のトランザクションを支える数千台のサーバーを稼働させています。すべてのノードを正常かつ同期した状態に保ち、それに依存するアプリケーションを稼働し続けさせることが、私たちのビジネスです。
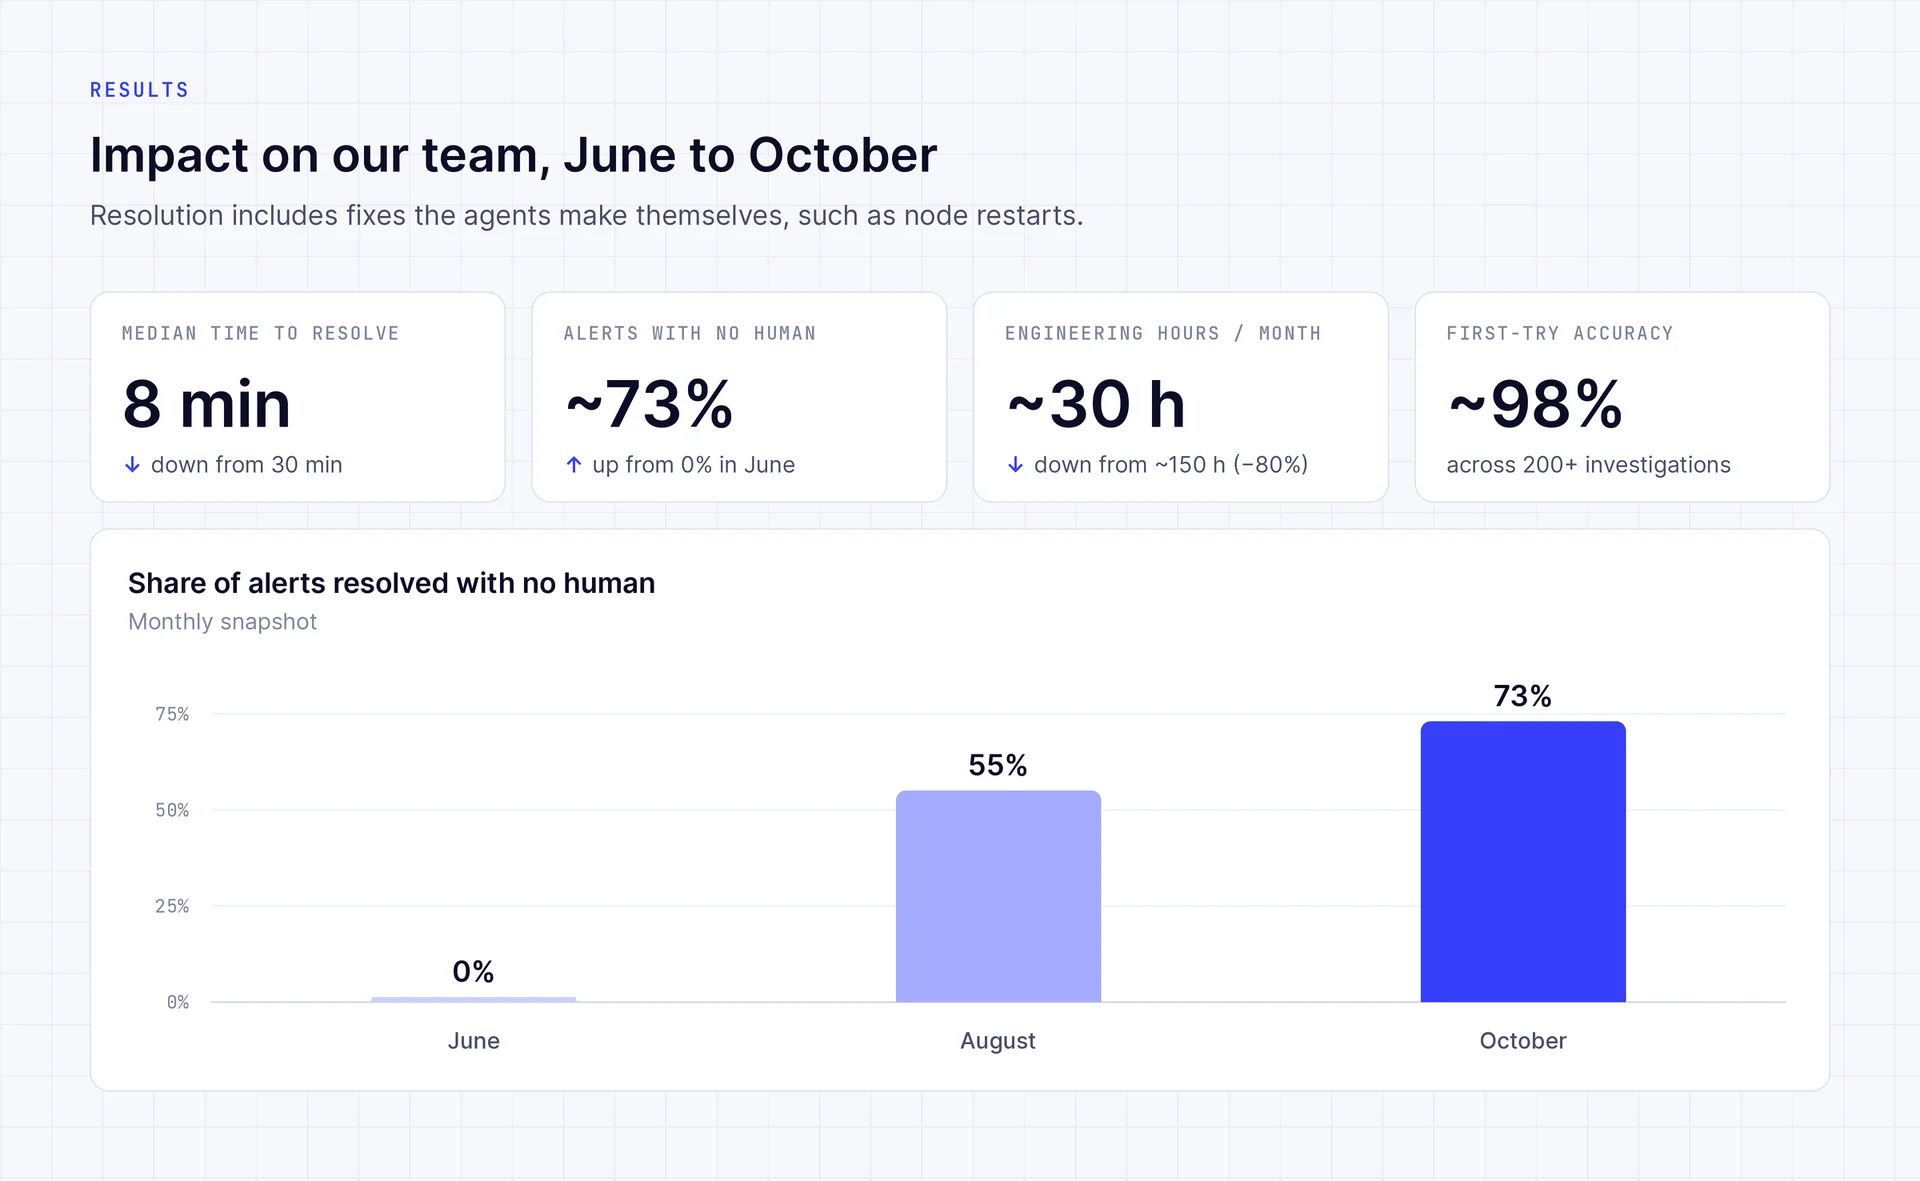
過去4か月間で、私たちはインシデントを調査し解決するために、ブロックチェーンネットワークごとに1つ、合計230以上の個別のエージェントを管理するエージェントファクトリーを構築しました。アラート解決時間の中央値は現在8分で、人が対応していたときの30分から短縮されました。エージェントはアラートの約73%を人の介入なしで解決しており、毎月約120時間のエンジニアリング時間が、問題の診断と修正ではなく、より生産的な作業に使われるようになりました。
課題: 多様なインフラ全体で週500件のアラート
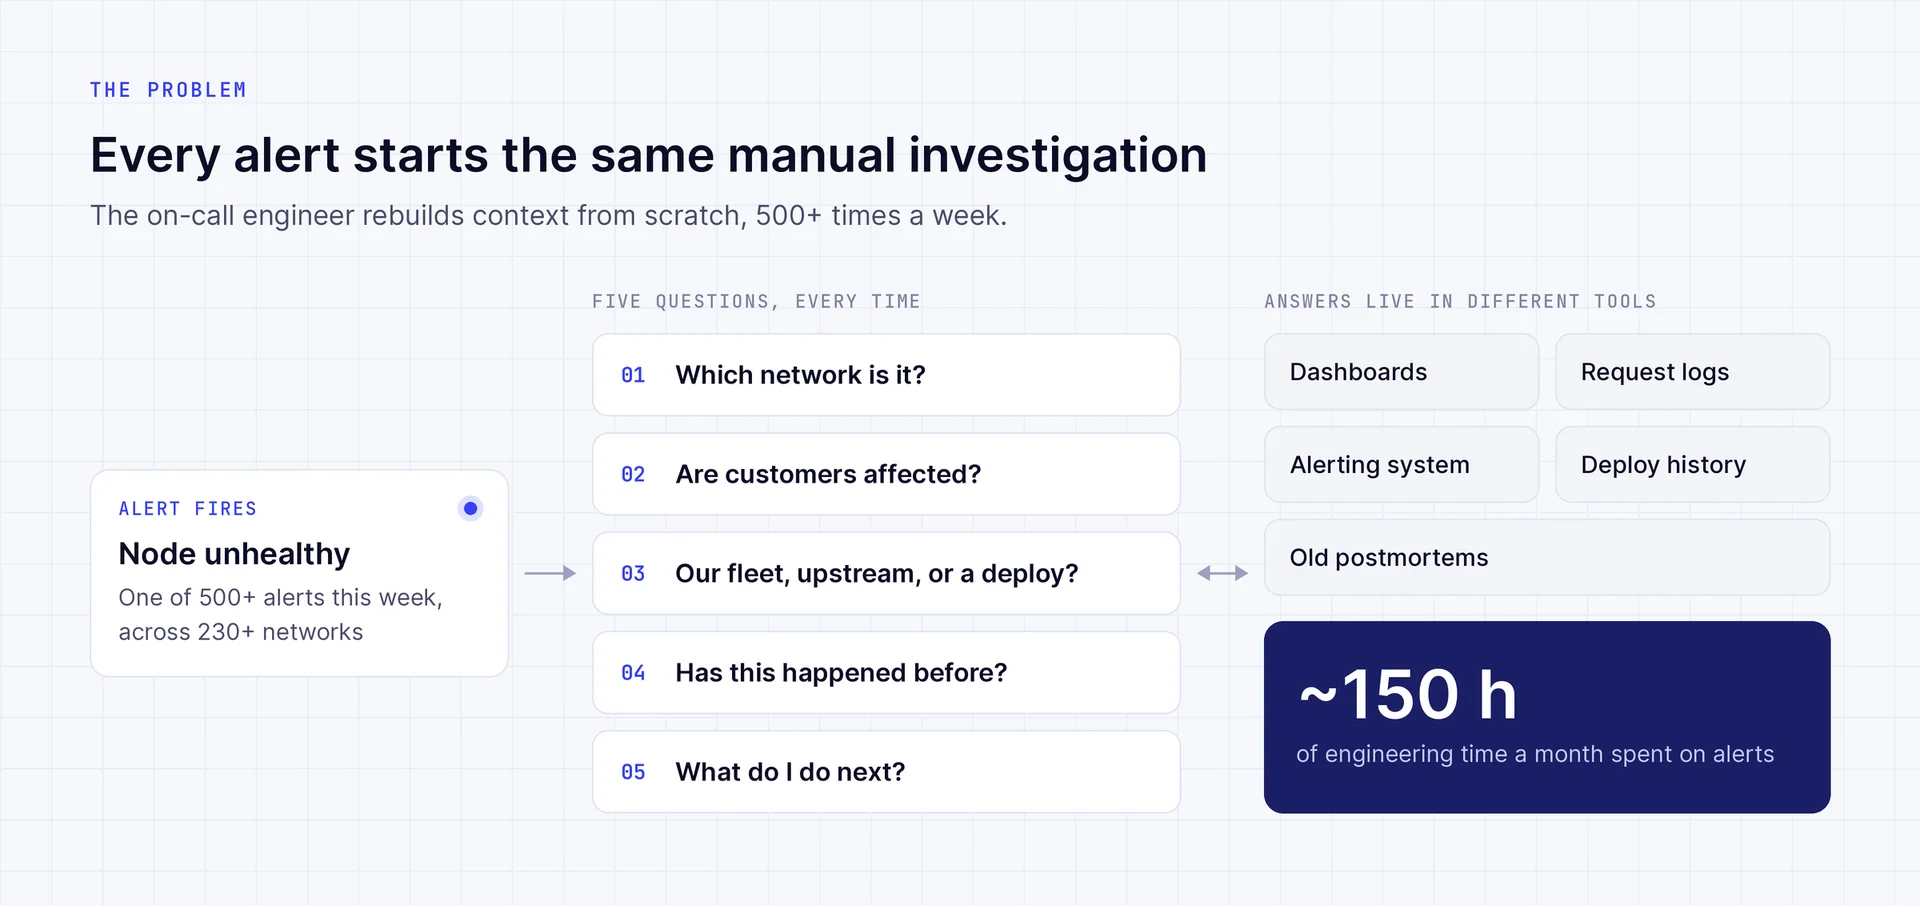
私たちのノードフリートは、Node Opsチームに対して週500件以上のアラートを発生させます。他のソフトウェアエンジニアリングチームと同様に、オンコールエンジニアはすべてのアラートについて同じ5つの質問で調査を進めます。
- どのネットワークか?
- 顧客は影響を受けているか?
- 問題は自社のフリートにあるのか、それともネットワーク自体のアップストリームにあるのか? デプロイが原因か?
- 以前にも起きたことがあるか?
- 次に何をすべきか?
答えは、ダッシュボード、リクエストログ、アラートシステム、デプロイ履歴、過去のポストモーテムに分散しています。これに500件のアラートと各ネットワーク固有の特性を掛け合わせると、原因の除去ではなく、コンテキストの再構築と問題の修復にかなりの時間が費やされます。
設計ルール: 判断に最適化する
すべてのツールにアクセスできるエージェントは、そのすべてを読もうとします。その結果、エンジニアがさらに読み込まなければならない長いレポートができあがります。エンジニアに必要なのは、より多くのデータではありません。必要なのは判断です。このアラートに人の対応が必要か、そしてどれだけ急ぐべきか。
そこで私たちのルールは1つです。判断に最適化する。
仕組み
1. 人を呼ぶ前に影響を特定する
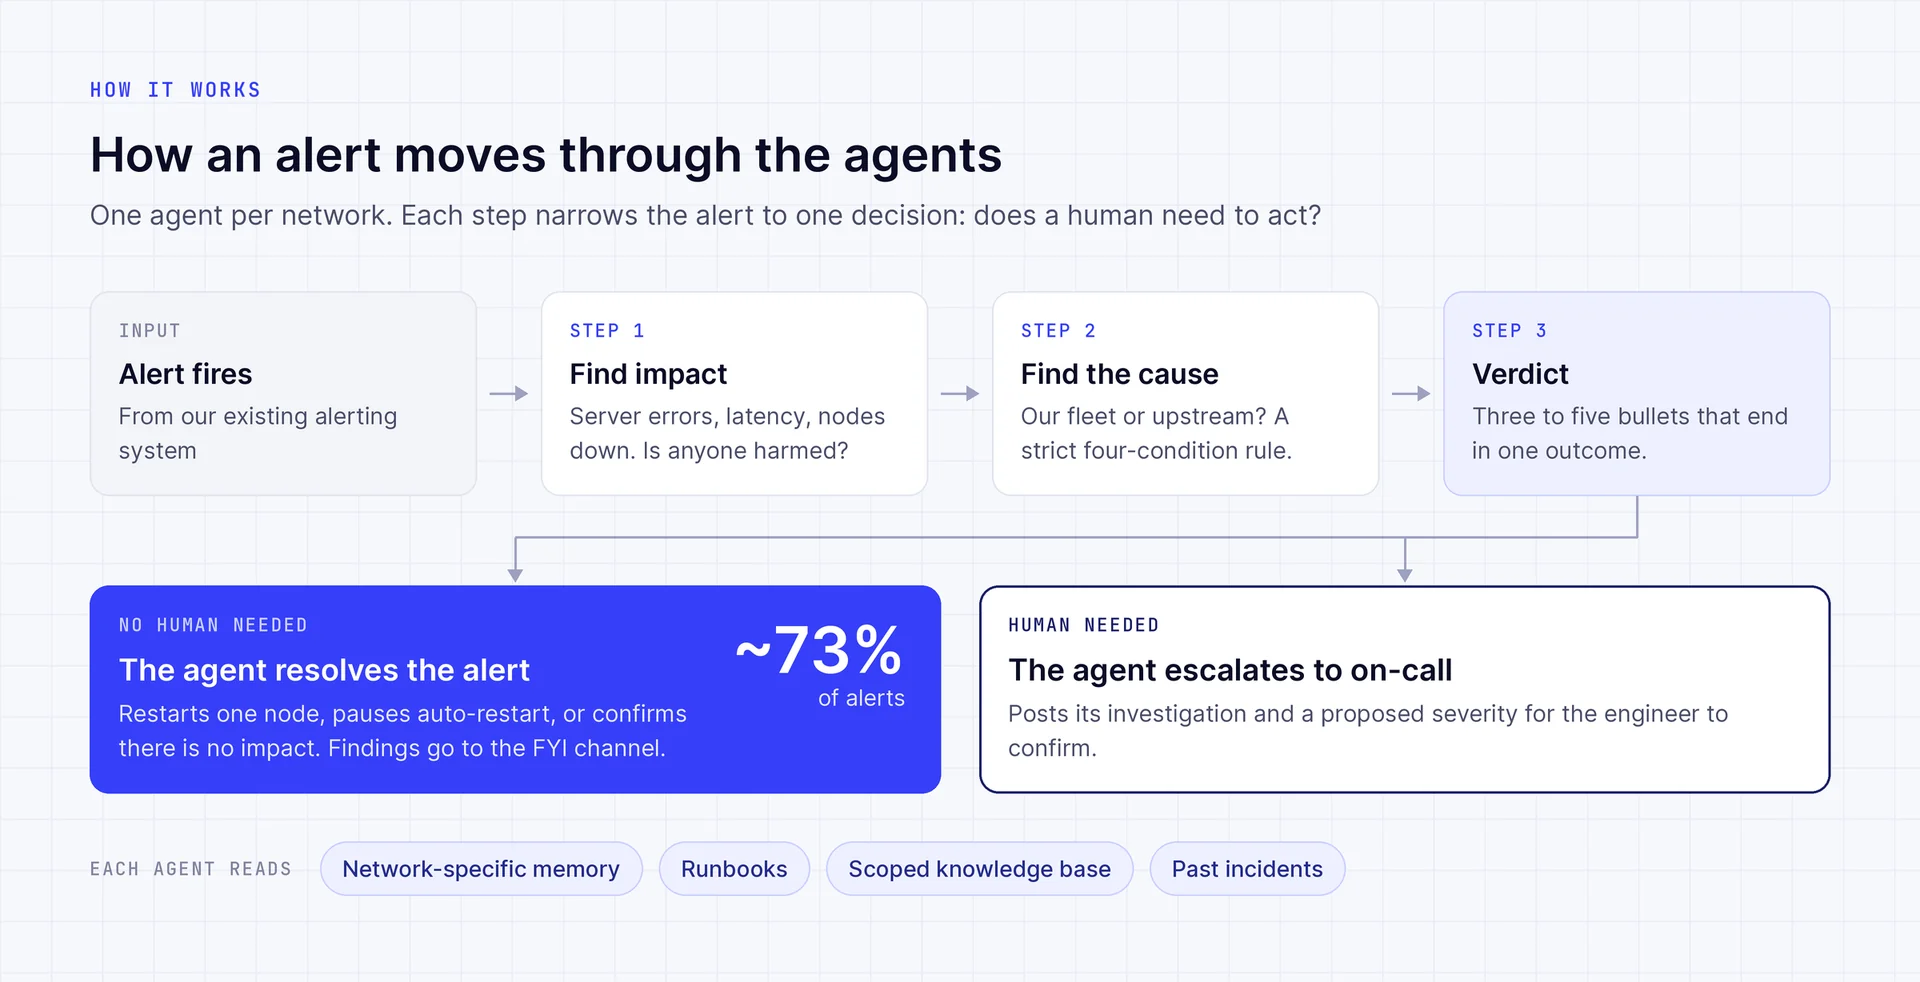
私たちのアラートシステムは、すでに週500回以上問題を検出しています。エージェントがそれを再度検出する必要はありません。エージェントの仕事は、誰かが対応すべきかどうかを判断することです。
発生したアラートが自動的にインシデントになるわけではありません。 アラートがインシデントになるのは、顧客向けのサーバーエラー、レイテンシの大幅な上昇、フリート内のすべてのノードのダウンなど、実際の被害の証拠をエージェントが見つけた場合だけです。
被害が見つからない場合、エージェントは調査結果を別の「FYI」チャンネルに投稿します。オンコールチャンネルに届くのは実際のインシデントだけです。
2. 判定を伴う調査
エージェントは3〜5個の箇条書きを投稿し、その結論は2つのいずれかになります。人の対応が不要な場合、エージェントがアラートを自ら解決します。人の対応が必要な場合、より詳しい調査結果をオンコールチャンネルに投稿します。
実際の例を5つ紹介します。
エンジニアはまず結果を読み、必要な場合にだけ証拠を読みます。
3. コードが強制する制限の範囲内で行動する
前述のとおり、解決は人の介入なしで行われることがよくあります。私たちはエージェントに、サービスを復旧するために異常なノードを再起動する機能と、ノードの設定が想定と一致しなくなったときに設定ドリフトを報告する機能を与えました。
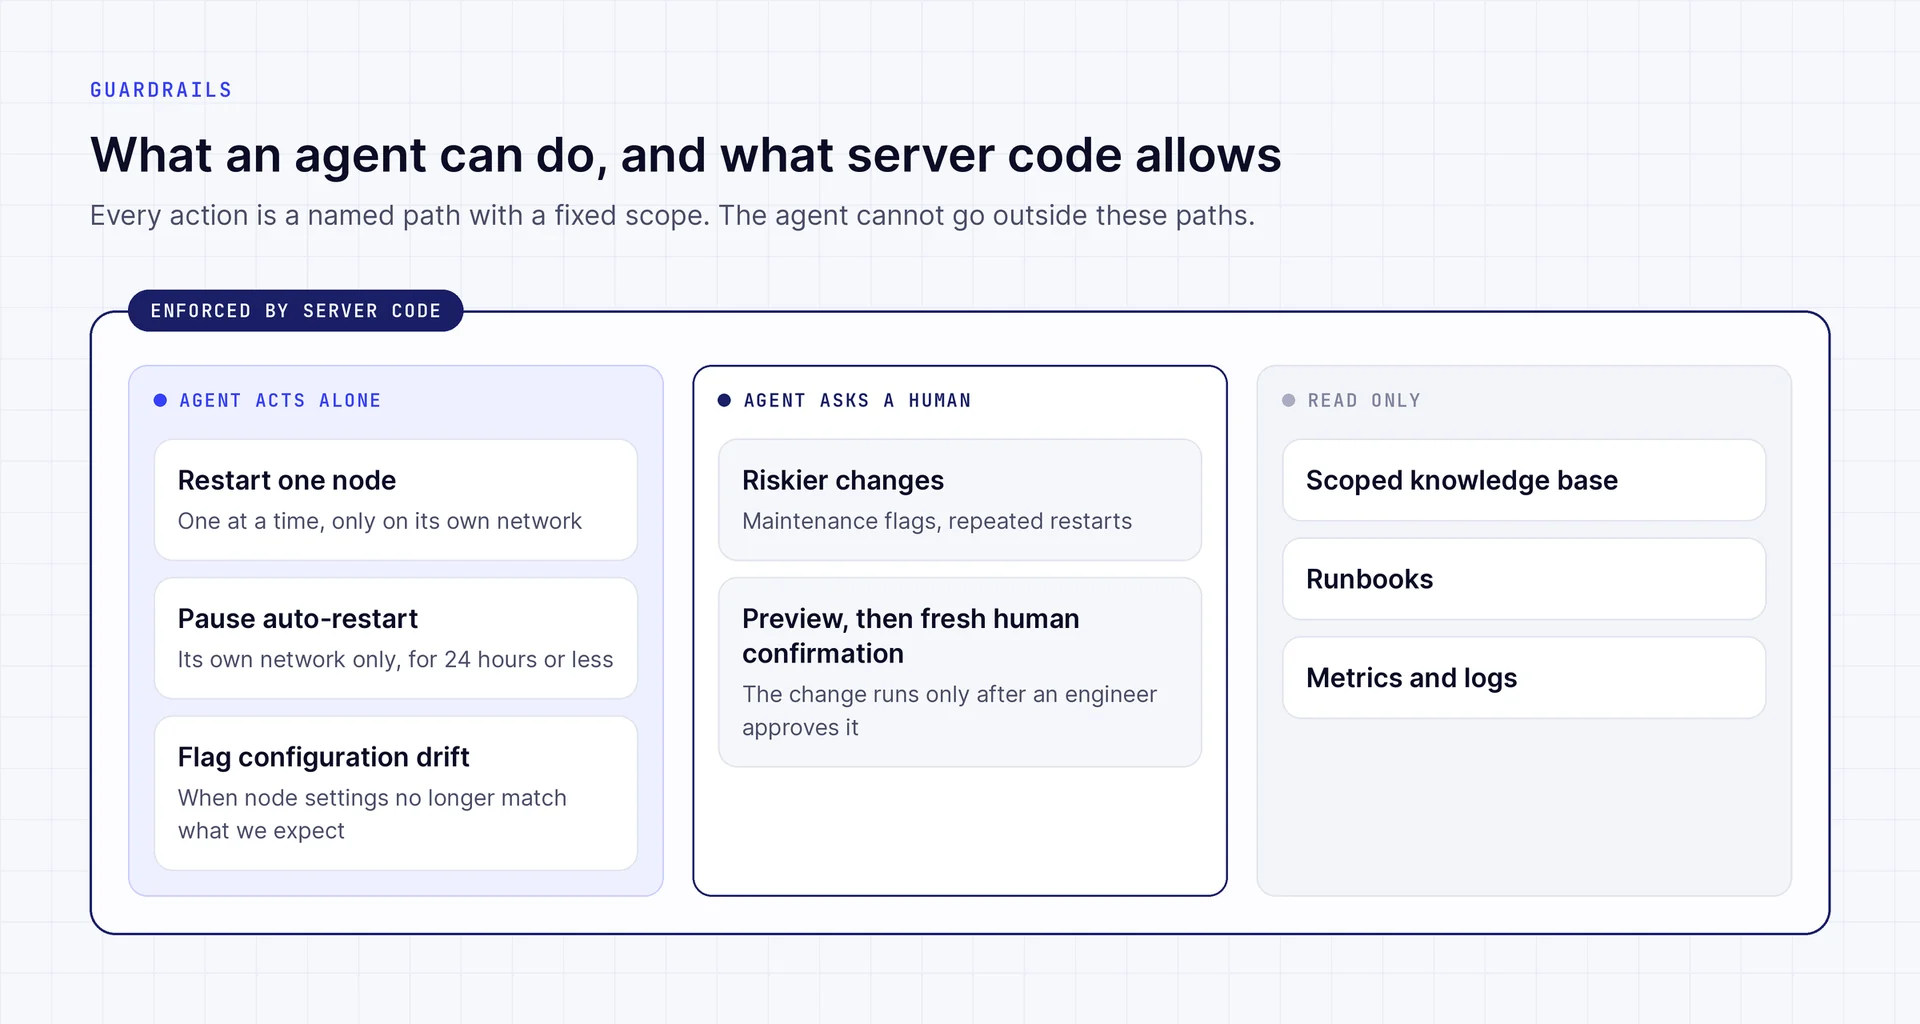
各アクションの範囲は狭く、サーバーコードがそれを強制します。エージェントができることは次のとおりです。
- 1つのネットワークにつき、一度に1つのノードだけを再起動する。これにより、一度に多くの容量を取り除くことはできません。
- データ破損を防ぐため、自身のネットワークの自動再起動システムを最大24時間一時停止する。
- 人に対応を依頼する。メンテナンスフラグや繰り返しの再起動など、リスクの高い変更には、プレビューと、その後の新たな人による確認が必要です。
これらの経路以外では、エージェントは範囲を限定されたナレッジベースとプレイブックからデータを読むだけです。エージェントに本番環境のインフラを操作させる場合、エージェントのアクセス範囲を限定することが最も重要です。
4. 「アップストリームが原因」を最も厳しい結論にする
ブロックチェーンノードを運用する面白さ(少なくとも私たちは面白いと考えています)は、ノードが本質的に不安定であることです。クライアントには問題が起こりえますし、すべてのネットワークがさまざまなワークロードの下で同じように動作するわけではありません。また、アップストリームのネットワーク運営者(バリデーター、シーケンサーなど)が、私たちのインフラの停止や障害を引き起こすこともあります。そのため、すべてのエージェントにはネットワーク固有のメモリと指示が必要です。それは「原因は自社か、それとも相手側か?」という1つの質問に答えるためです。
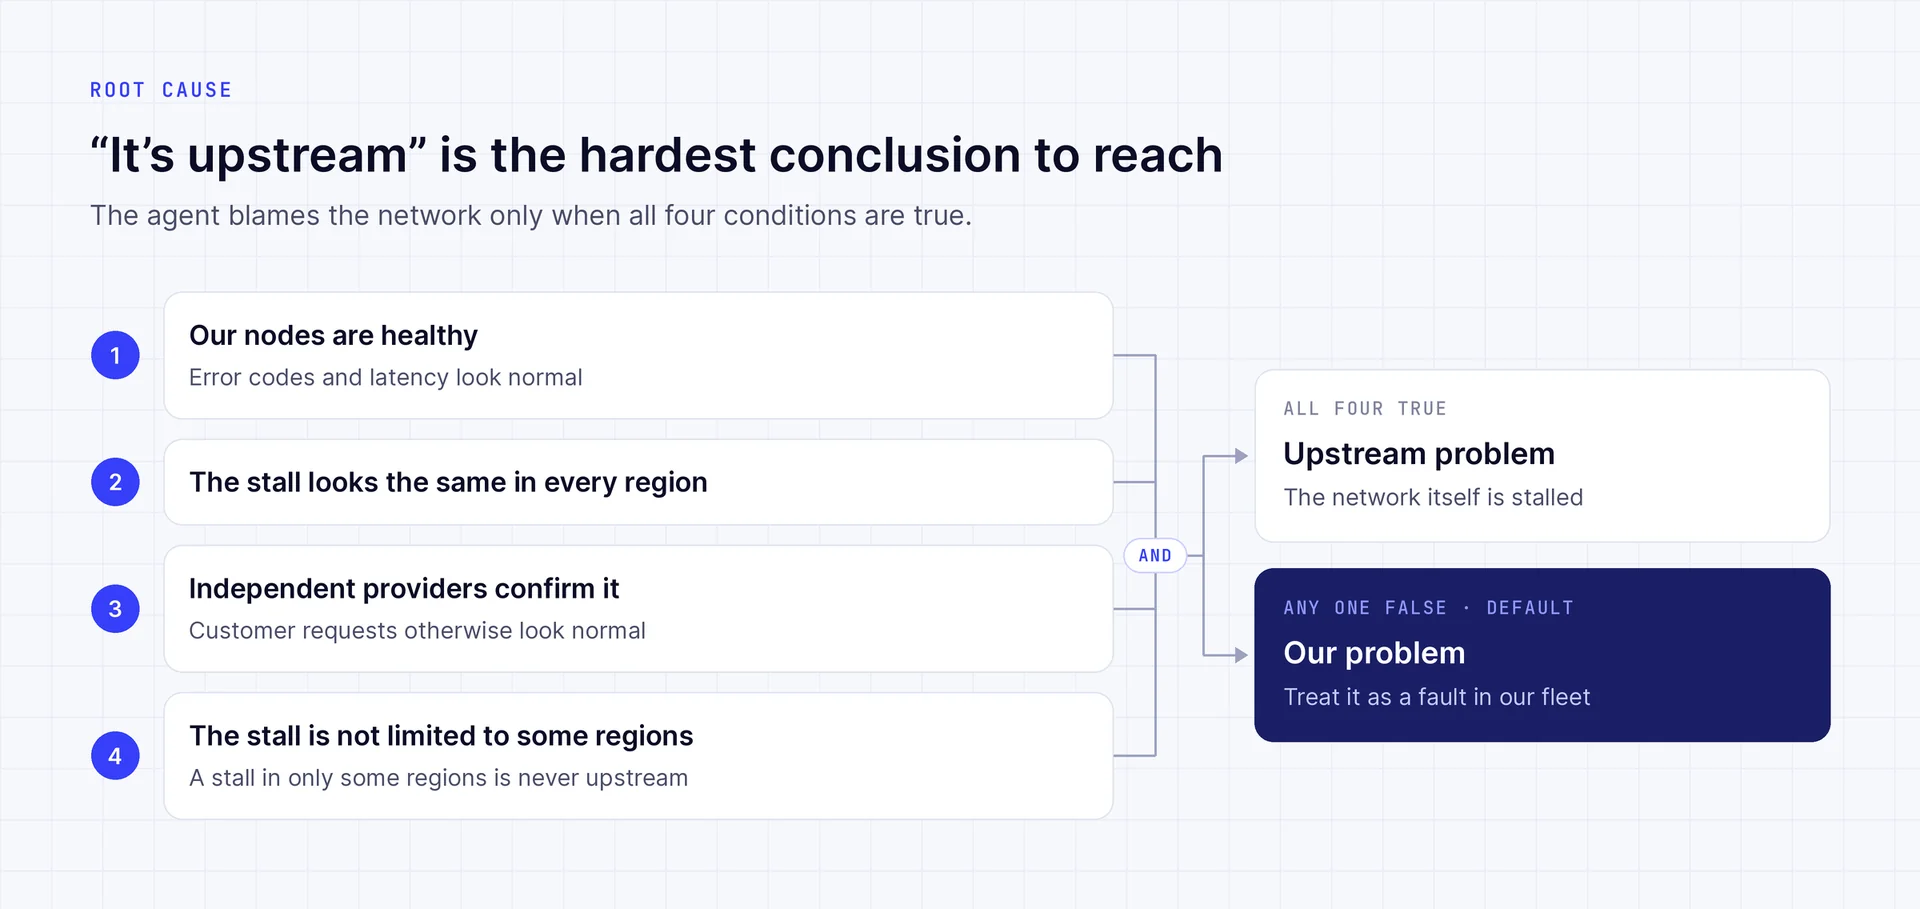
エージェントが「アップストリーム」と判断するには、4つの条件を満たす必要があります。
- エラー率とレイテンシの観点から、自社のノードが正常であること。
- アップストリームのエラー(たとえばネットワークの「停止」)が、運用しているすべてのリージョンで同じように見えること。
- 独立したプロバイダーがそれを確認し、それ以外の点では顧客のリクエストが正常に見えること。
- 一部のリージョンだけで発生している停止は、決してアップストリームではない。
このルールは双方向に機能します。あるアラートでは、6つのノードが異常でしたが、ネットワークは新しいブロックを生成し続けていました。エージェントはこれをアップストリームの停止ではなく、自社のサービング側の問題と判断しました。
結果: 信頼性の向上と解決の高速化
これらの投資により、エンジニアリング時間は意味のある作業に使われ、顧客はどのネットワークで開発していても、問題をより早く解決してもらえるようになりました。
- アラートの解決がほぼ4倍高速に。 解決時間の中央値は30分から8分に短縮されました。
- ほとんどのアラートにエンジニアは不要。 エージェントはアラートの約73%を自ら解決しています。6月時点では0%でした。
- チームは月約120時間を取り戻した。 アラート対応に費やすエンジニアリング時間は月約150時間から約30時間に減り、80%削減されました。これは毎月約3エンジニア週に相当し、その時間はコンテキストの再構築ではなく原因の除去に使われています。
- エージェントは最初の判断で正しい。 過去1か月間の200件以上の調査で、初回の根本原因特定の精度は約98%でした。
独自のオンコールエージェントを構築するチームへのアドバイス
- 成果を測定する。 オンコールエージェントは、解決時間、精度、削減したエンジニアリング時間で評価してください。
- 判定を求める。 1ページ分の調査結果を返すエージェントは、作業を移しただけで、なくしてはいません。最初に判断を示すことを求めてください。解決するか、人を呼んでどれだけ急ぐかを伝えるかです。
- 範囲を固定した名前付きのアクションを与える。 24時間の上限付きの単一ノード再起動は、生のシェルアクセスよりも安全です。
- 各エージェントに狭い担当範囲と長いメモリを与える。 そのネットワークのランブック、特性、インシデント履歴を持つネットワークごとの1エージェントは、アラートのたびにシステムを再発見する必要がありません。今日これが7回目の停止であることを、すでに知っています。
しかし最も重要なのは、問題の調査で終わらせないことです。問題が人に届く前にそれを防ぐことができるエージェントは、顧客価値に費やすエンジニアリングの労力を積み重ねていきます。
応用AIとインフラのこうした交差領域に興味がありますか?
- @onewaysidewalks をフォローして、AlchemyのAIに関する最新情報を入手してください。
- チームに参加する。採用中です。
Alchemy Newsletter
リリース情報をいち早く受け取る
ニュースレターに登録する
Alchemyの最新のプロダクト情報とリソースをお届けします
メールアドレスを入力すると、当社のマーケティング情報およびプロダクト最新情報の受信に同意したことになります。Alchemyが受け取った情報をプライバシー通知に従って取り扱うことに同意するものとします。購読はいつでも解除できます。
関連記事
Glamsterdam: Ethereum開発者のための完全ガイド
GlamsterdamはSepoliaで稼働中です。開発者にとって何を意味するか、Alchemyがネットワークアップグレードにどう備えたかをまとめた完全ガイドです。
東京で構築するなら、どのRPCプロバイダーを選ぶべきか
東京を提供するRPCプロバイダー5社を、5つのチェーンでベンチマークした。比較結果と、レイテンシに敏感なチームにとって差が出るポイントを示す。
業界最速クラスの速度と信頼性を実現するSolana RPC読み取りの設計
AlchemyはSolanaの読み取りレイテンシが最も低く、9.21ミリ秒で、次点のプロバイダーより約26%高速です。