我們為每條區塊鏈都配置了專屬的待命代理
Alchemy 如何使用 230 多個代理對節點群的警示進行分類與修復
Alchemy 為 230 多個區塊鏈網路運行基礎設施,營運數千台伺服器,每年支援超過 1 兆美元的交易。我們的業務就是讓每個節點保持健康與同步,讓仰賴它的應用程式持續正常運作。
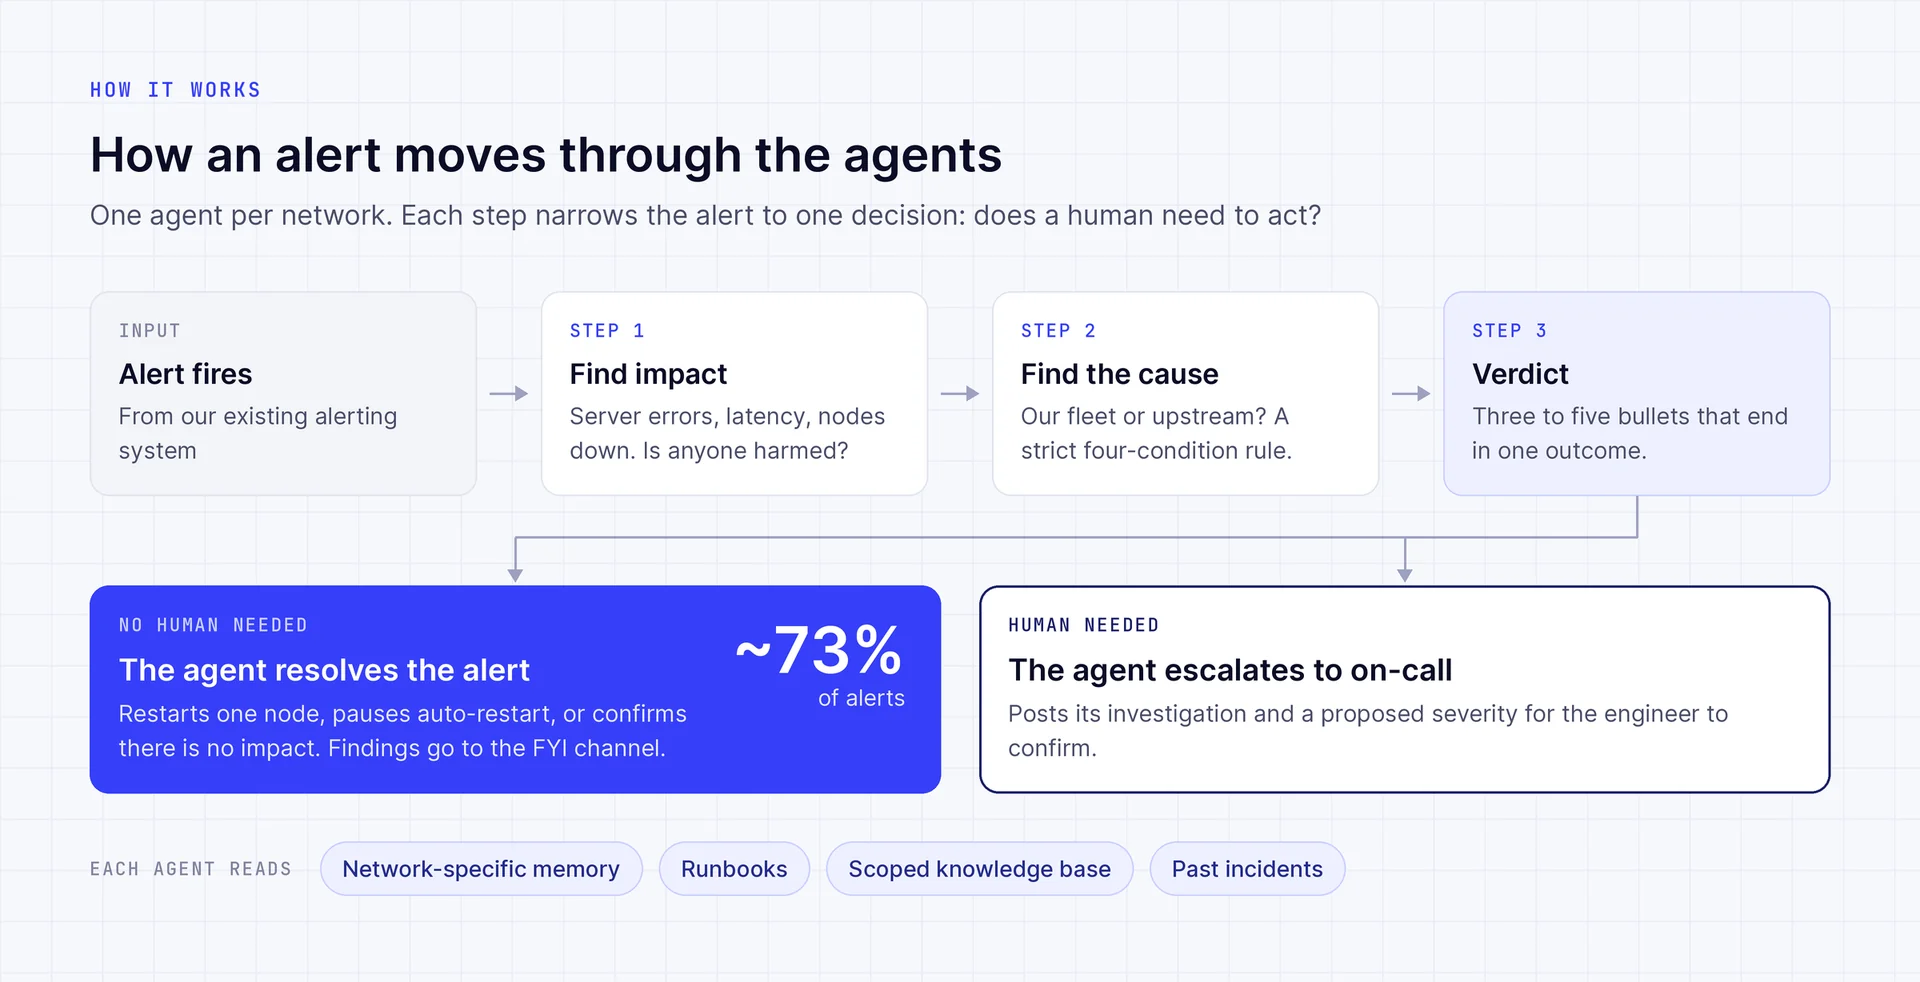
在過去四個月裡,我們建構了一座代理工廠,管理 230 多個各自獨立的代理,每個區塊鏈網路一個,用來調查並解決事故。現在,警示解決時間的中位數為 8 分鐘,而由人工處理時為 30 分鐘。約 73% 的警示由代理在無人介入的情況下解決,每月約 120 個工程小時不再用於診斷與修復問題,而是轉向更有價值的工作。
問題:多樣化基礎設施每週產生 500 則警示
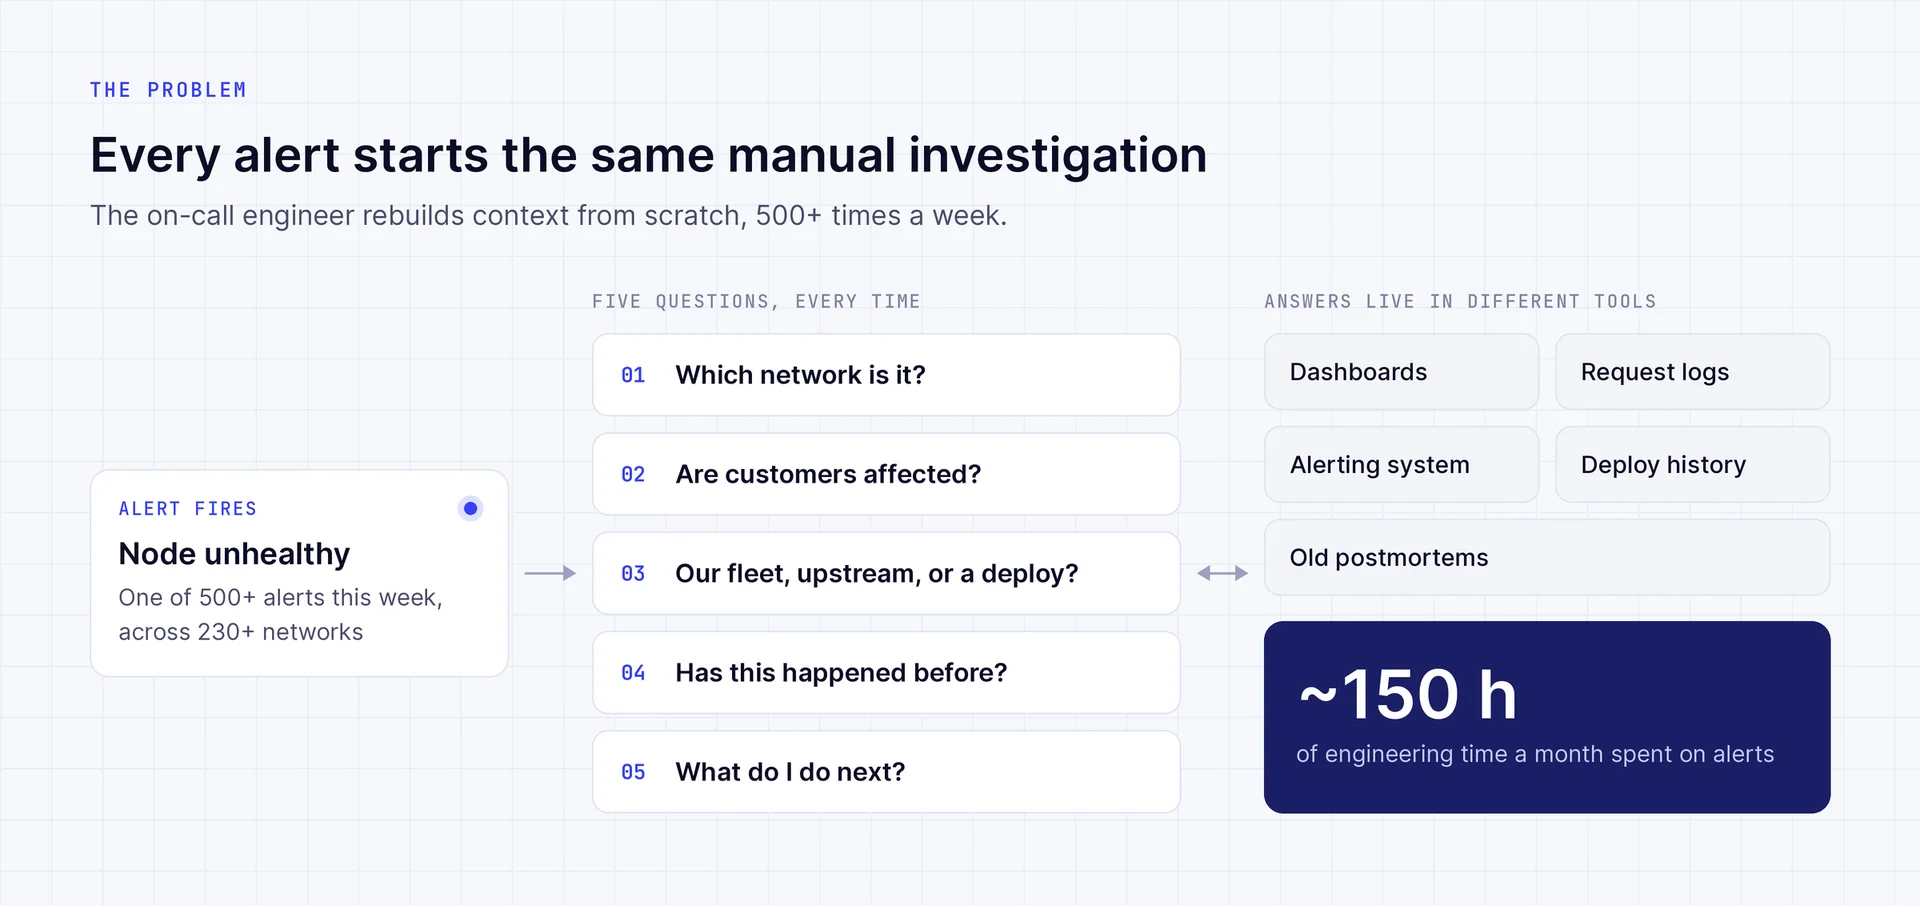
我們的節點群每週為 Node Ops 團隊產生 500 多則警示。和任何軟體工程團隊一樣,待命工程師會對每則警示進行同樣的五問調查:
- 是哪個網路?
- 客戶是否受到影響?
- 問題出在我們的節點群,還是上游的網路本身?會不會是某次部署?
- 以前發生過嗎?
- 下一步該做什麼?
這些答案分散在儀表板、請求日誌、警示系統、部署歷史與過去的事後檢討中。乘以 500 則警示,再加上每個網路各自的特性,大量時間被用於重建脈絡與修復問題,而不是消除根源。
設計原則:為決策而最佳化
一個能存取所有工具的代理會把所有工具都讀一遍。結果是一份冗長的報告,工程師仍需從中翻找。工程師需要的不是更多資料,而是一個決策:這則警示是否需要人工處理,緊急程度如何?
因此我們只有一條原則:為決策而最佳化。
運作方式
1. 先確認影響,再打擾人工
我們的警示系統已經在偵測問題,每週 500 多次。代理不需要重複偵測。它們的任務是判斷是否有人需要關注。
觸發的警示不自動等於事故。 只有當代理找到真實損害的證據時,警示才會成為事故,例如面向客戶的伺服器錯誤、延遲顯著上升,或節點群中所有節點停擺。
如果代理沒有發現損害,它會把調查結果發布到另一個「FYI」頻道。只有真正的事故才會進入待命頻道。
2. 有判定的調查
代理發布三到五個重點,並以兩種結果之一收尾。如果不需要人工,代理會自行解決警示。如果需要人工,它會把更深入的調查結果發布到待命頻道。
五個真實範例:
工程師先讀結果,再看證據,甚至可以不看證據。
3. 在程式碼強制執行的限制內行動
如上所述,解決警示通常不需要人工介入。我們賦予代理重新啟動不健康節點以恢復服務的能力,以及在節點設定與預期不符時標記設定漂移的能力。
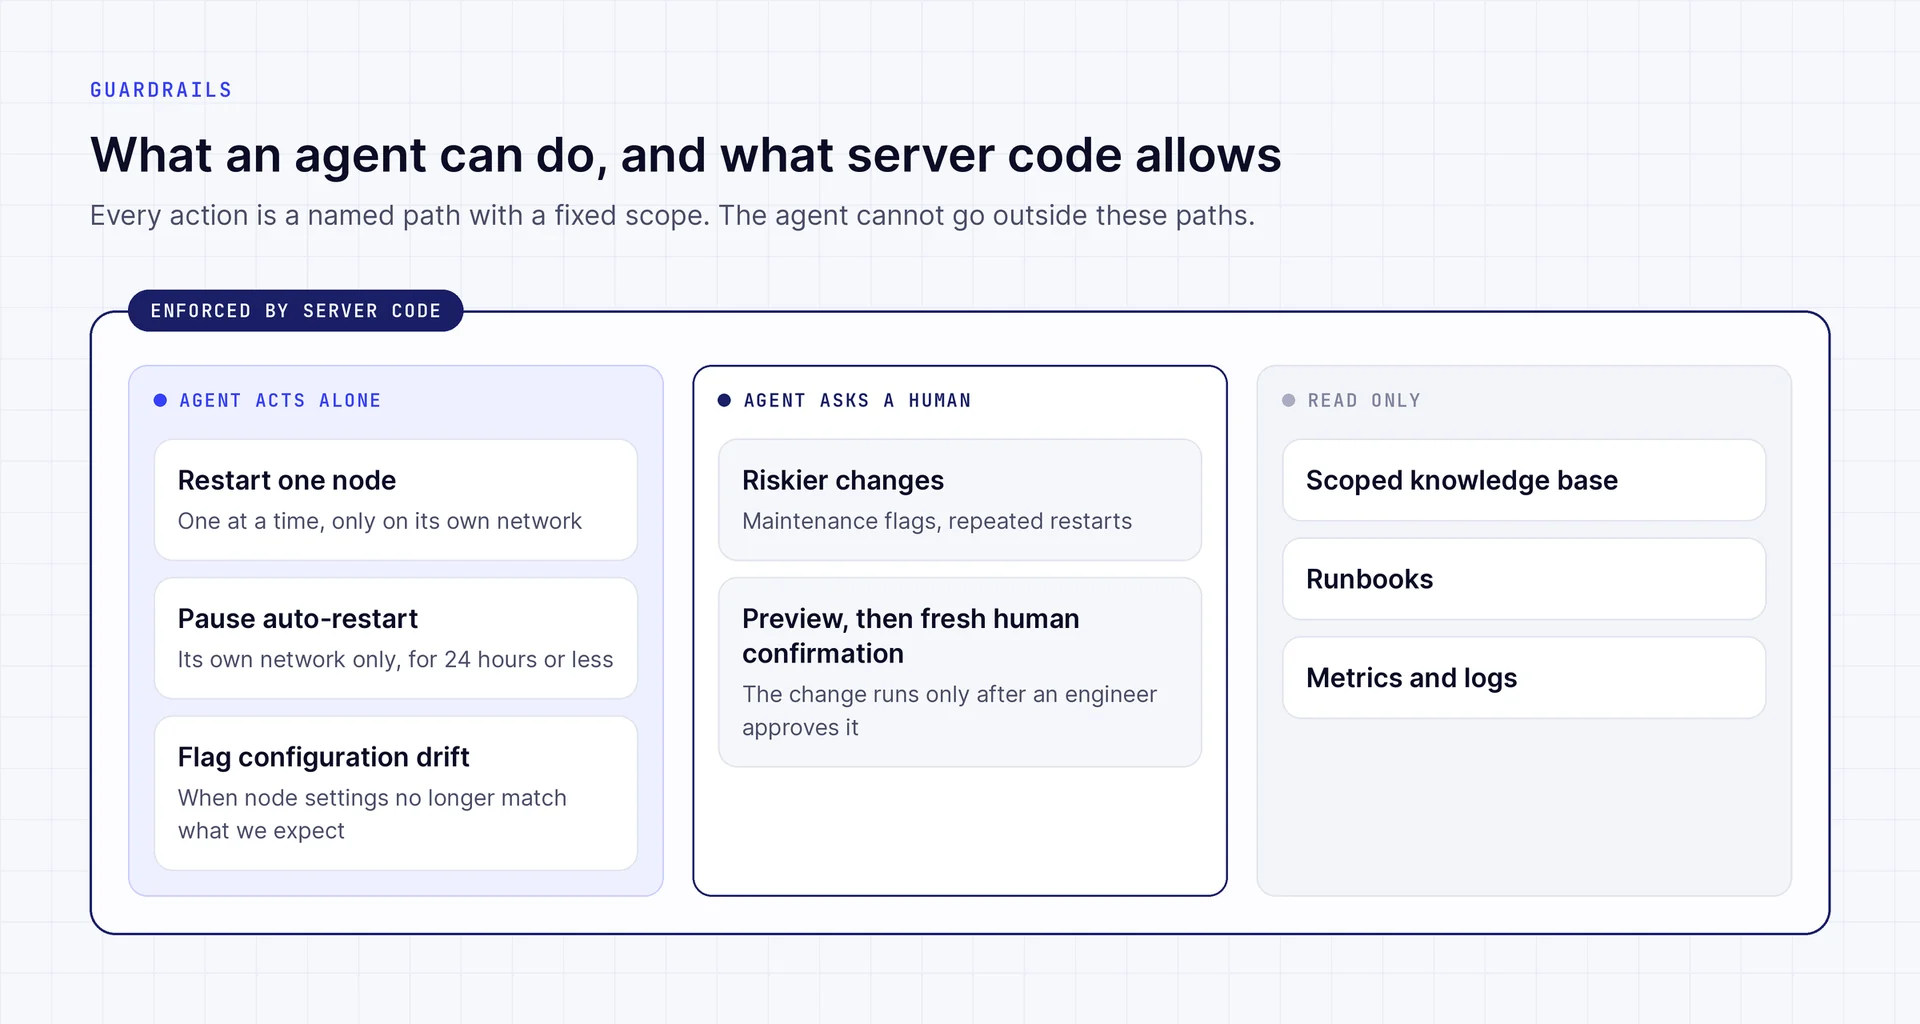
每個操作的範圍都很窄,並由伺服器程式碼強制執行。代理可以:
- 每次只為一個網路重新啟動一個節點,因此不會一次移除過多容量。
- 為自己負責的網路暫停自動重新啟動系統,最長 24 小時,以避免資料損毀。
- 請求人工介入。風險較高的變更,例如維護旗標或重複重新啟動,需要先預覽,再由人工重新確認。
除了這些路徑之外,代理只從其限定範圍內的知識庫與應變手冊中讀取資料。讓代理與線上正式環境基礎設施互動時,限定代理的存取範圍是關鍵。
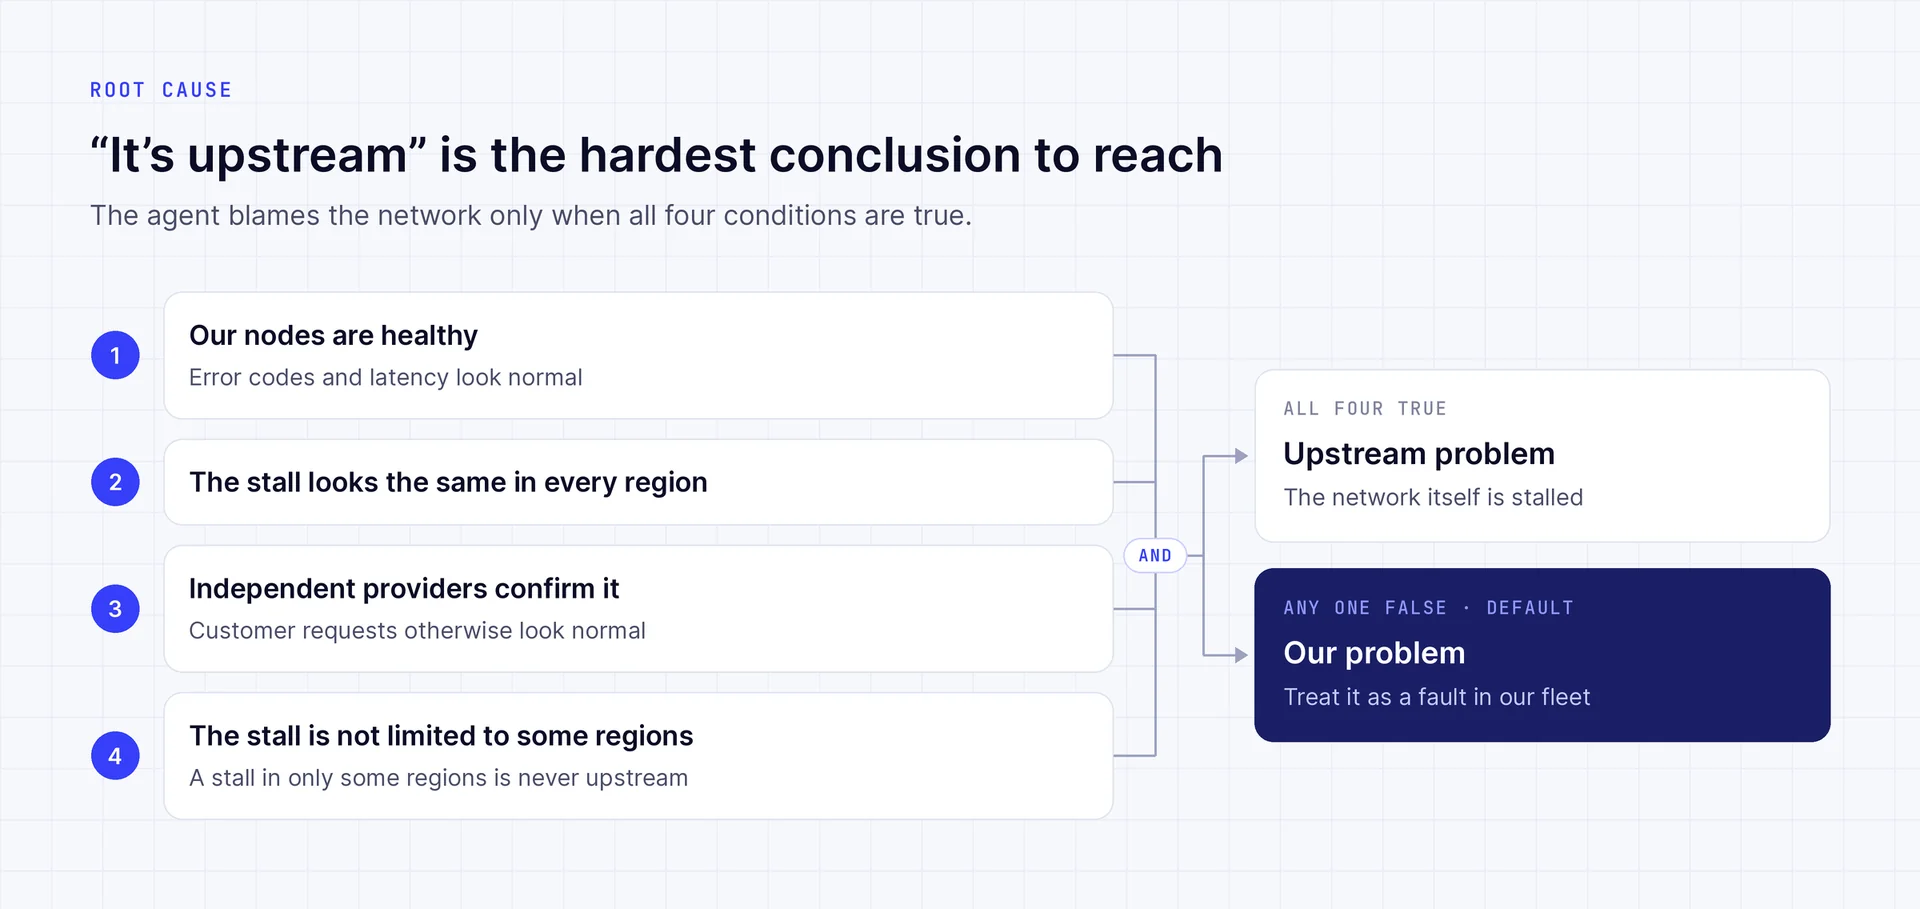
4. 讓「問題在上游」成為最難得出的結論
運行區塊鏈節點的樂趣(至少我們認為是樂趣)在於,它們本質上就不可靠。客戶端可能出問題,不同網路在不同工作負載下的表現並不一致,上游網路營運方(驗證者、排序器等)也可能導致我們的基礎設施停滯或故障。因此,每個代理都需要針對特定網路的記憶與指示,用來回答一個問題:「是我們的問題,還是他們的問題?」
代理必須滿足四個條件,才能判定為「上游」問題:
- 從錯誤率與延遲來看,我們的節點必須是健康的。
- 上游錯誤(例如網路「停滯」)在我們運行的每個區域中必須表現一致。
- 必須有獨立的供應商確認,而且客戶請求在其他方面看起來正常。
- 只出現在部分區域的停滯絕不是上游問題。
這條規則雙向適用。在一則警示中,有六個節點不健康,但網路仍在產生新區塊。代理判定這是我們的服務問題,而不是上游停滯。
成果:更高的可靠性,更快的解決速度
由於這些投入,工程時間用在了有意義的工作上,客戶在其建構的任何網路上遇到的問題也能更快獲得解決。
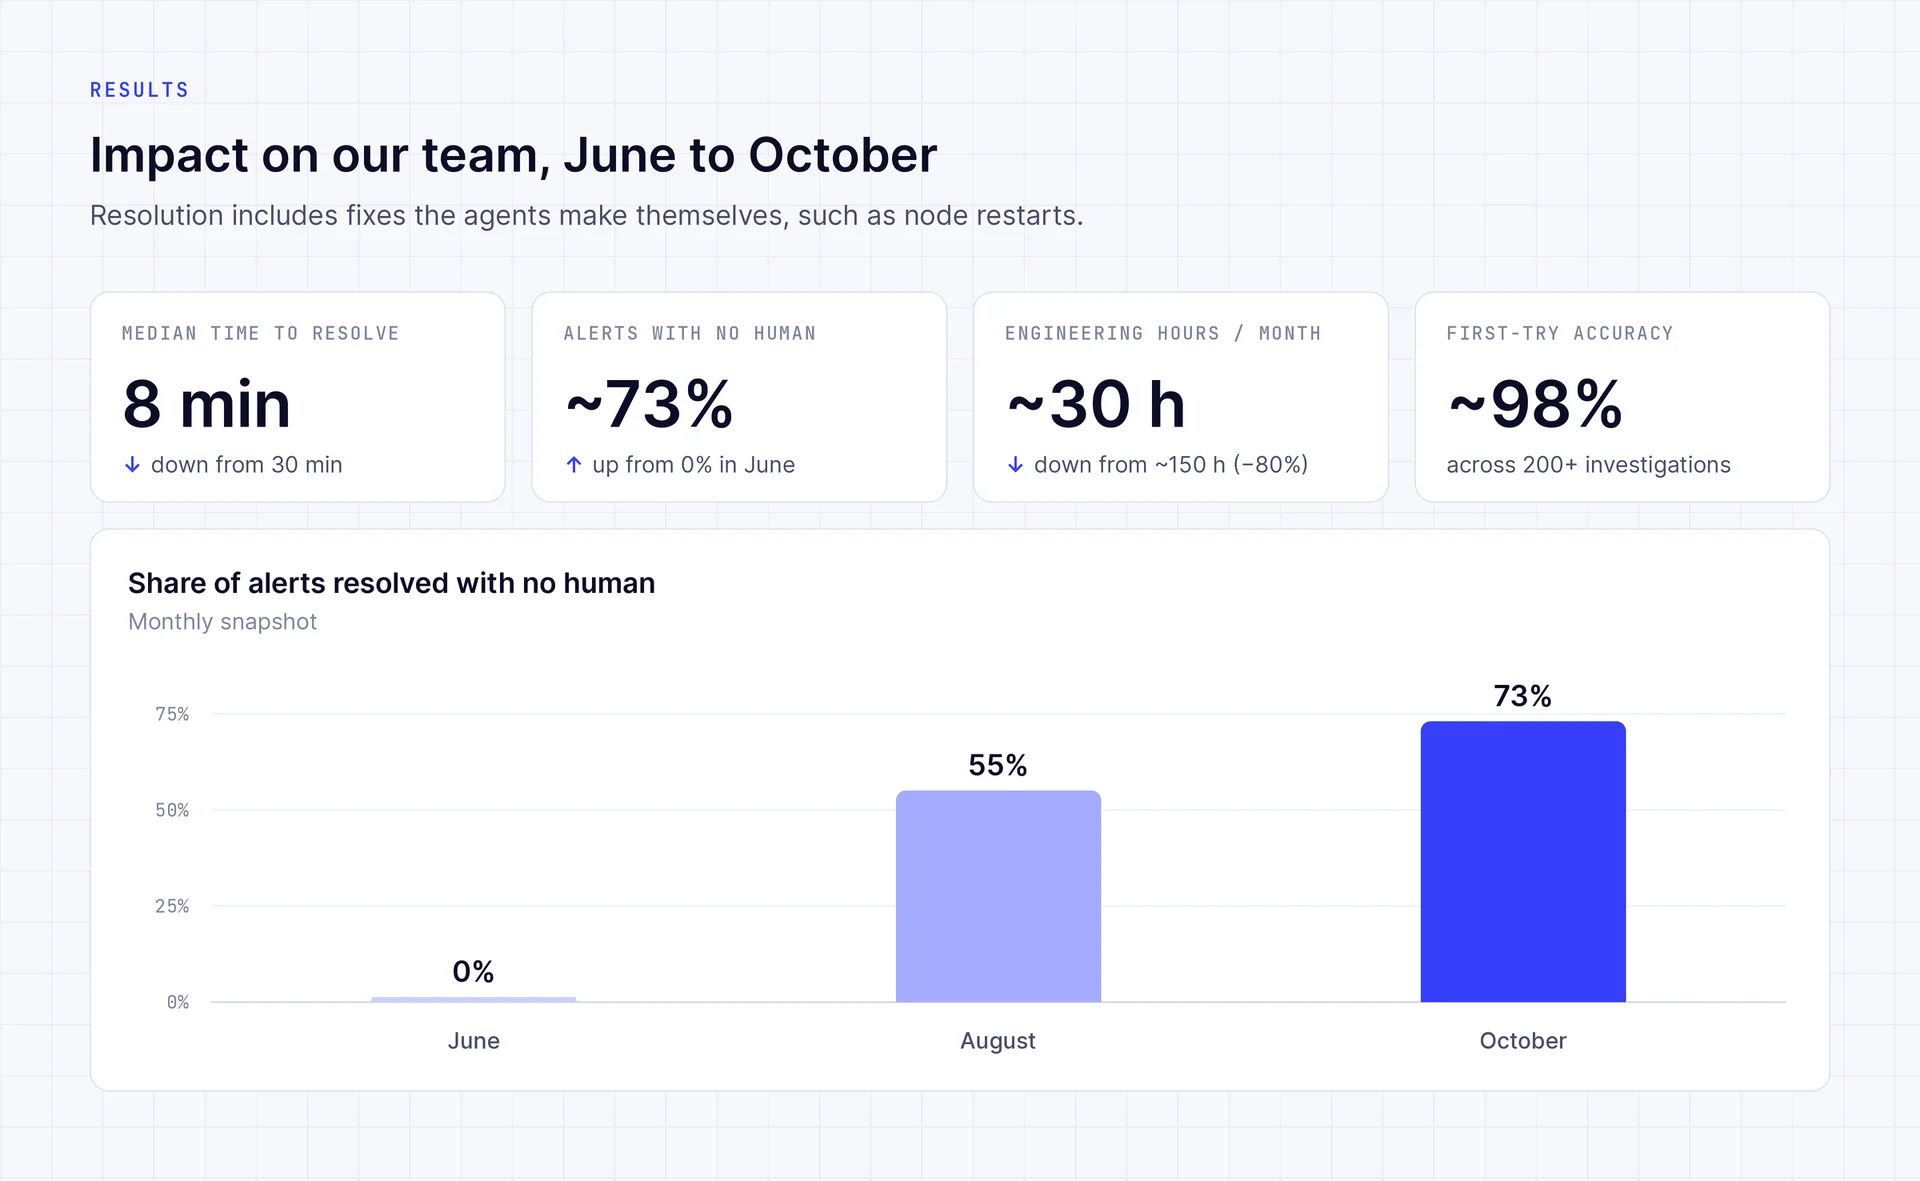
- 警示解決速度提升近四倍。 解決時間中位數從 30 分鐘降至 8 分鐘。
- 大多數警示不需要工程師處理。 代理自行解決約 73% 的警示,而 6 月時這個比例為 0%。
- 團隊每月省下約 120 小時。 處理警示的工程時間從每月約 150 小時降至約 30 小時,減少 80%。這相當於每月約三個工程師週,現在用於消除根源,而不是重建脈絡。
- 代理第一次判斷就正確。 在過去一個月的 200 多次調查中,首次根本原因判斷準確率約為 98%。
給建構自有待命代理的團隊的建議
- 衡量結果。 以解決時間、準確率與省下的工程小時來評估待命代理。
- 要求做出判定。 一個交回一整頁調查結果的代理只是轉移了工作,並沒有消除工作。要求它先給出決策:自行解決,或呼叫人工並說明緊急程度。
- 授予名稱明確、範圍固定的操作。 有 24 小時上限的單一節點重新啟動比原始 shell 存取更安全。
- 給每個代理劃定狹窄的職責範圍與長期記憶。 每個網路一個代理,並配有該網路的操作手冊、特性與事故歷史,就不必在每則警示上重新了解你的系統。它已經知道這是今天第七次停滯。
但最重要的是:不要止步於問題調查。 能夠預防問題到達人工的代理,會放大你投入在客戶價值上的工程心力。
喜歡這類應用 AI 與基礎設施的交叉內容嗎?
- 追蹤 @onewaysidewalks,掌握 Alchemy 在 AI 方面的最新動態。
- 加入我們的團隊。我們正在徵才!
Alchemy 電子報
搶先掌握最新發布消息
訂閱我們的電子報
取得 Alchemy 最新產品更新與資源
輸入您的電子郵件地址,即表示您同意接收我們的行銷通訊與產品更新。您了解 Alchemy 會依照我們的隱私權聲明處理所收到的資訊。您可以隨時取消訂閱。