Demos a cada blockchain seu próprio agente de plantão
Autor: Sam Raghunath
Como a Alchemy usa mais de 230 agentes para fazer a triagem e corrigir alertas em toda a nossa frota de nós
A Alchemy opera a infraestrutura de mais de 230 redes blockchain e gerencia milhares de servidores que processam mais de US$ 1 tri em transações por ano. Nosso negócio é manter cada nó saudável e sincronizado, para que as aplicações que dependem dele continuem funcionando.
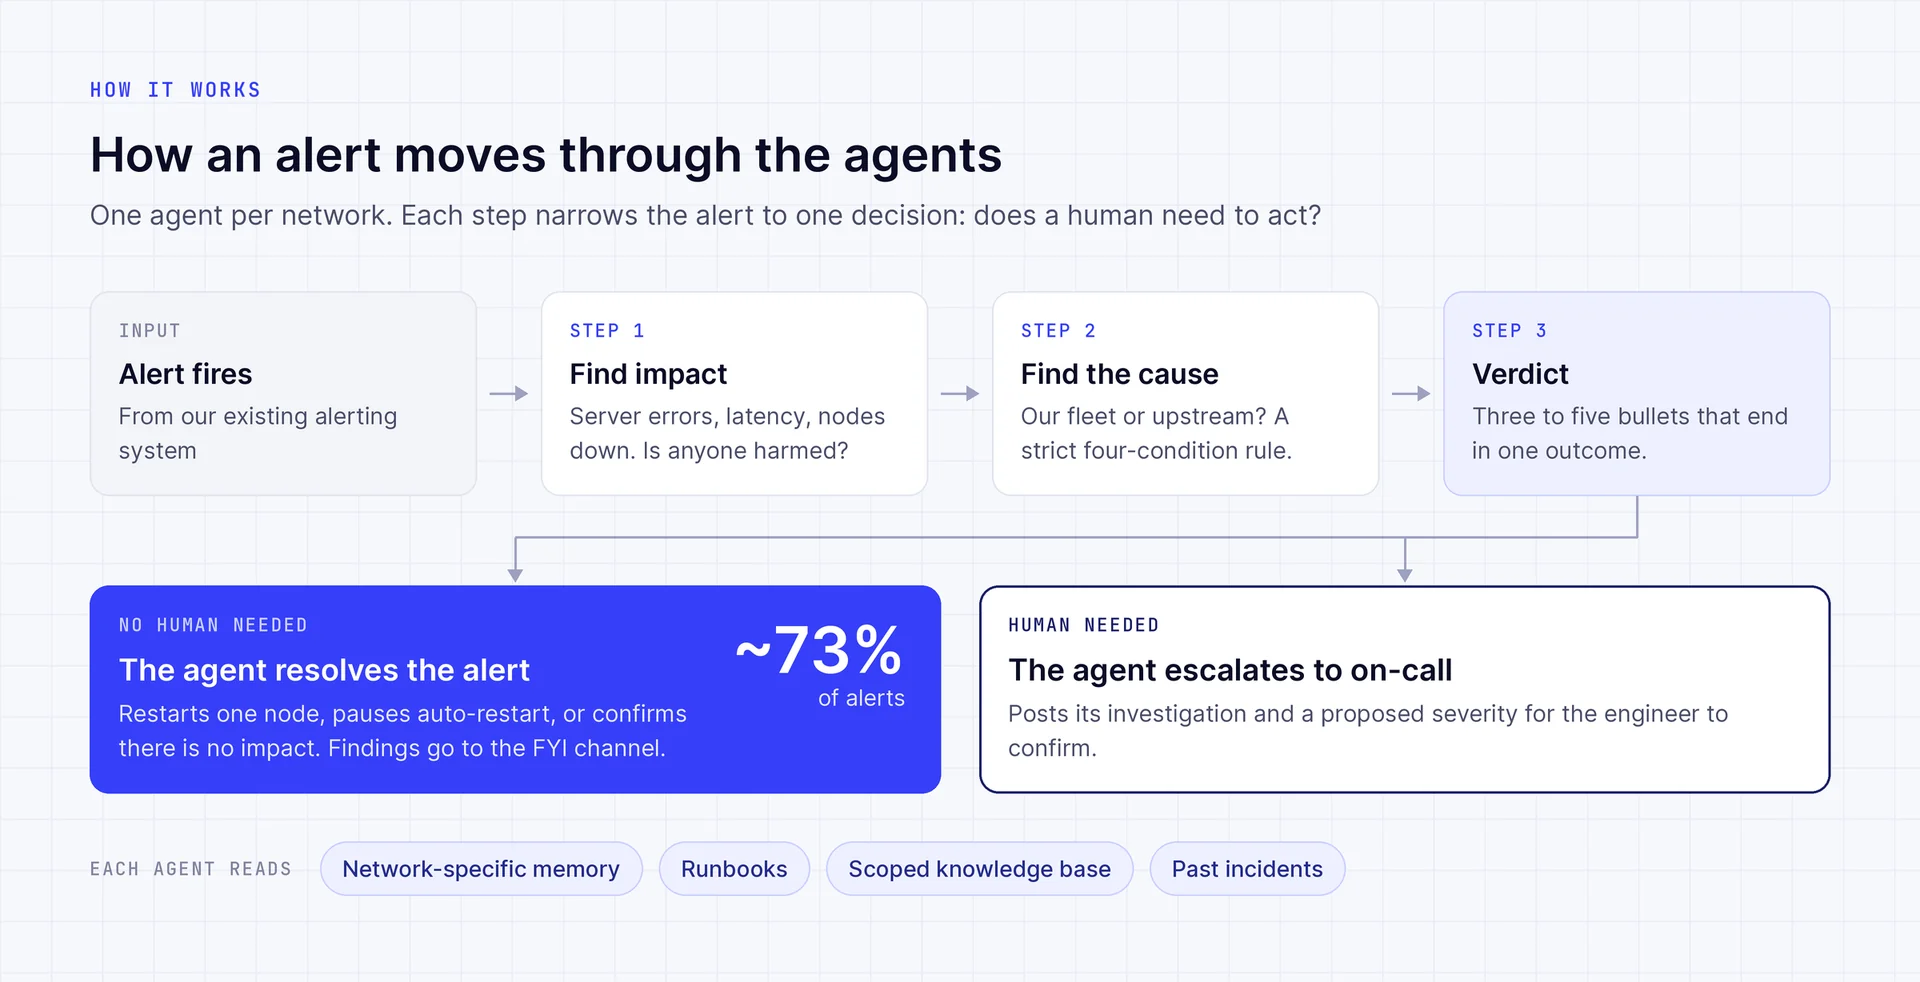
Nos últimos quatro meses, construímos uma fábrica de agentes que gerencia mais de 230 agentes distintos, um por rede blockchain, para investigar e resolver incidentes. A mediana do tempo de resolução de um alerta agora é de 8 minutos, contra 30 minutos quando uma pessoa resolvia. Os agentes resolvem cerca de 73% dos alertas sem nenhuma pessoa envolvida, e cerca de 120 horas de engenharia por mês agora vão para trabalho mais produtivo, em vez de diagnosticar e corrigir problemas.
O problema: 500 alertas por semana em uma infraestrutura diversa
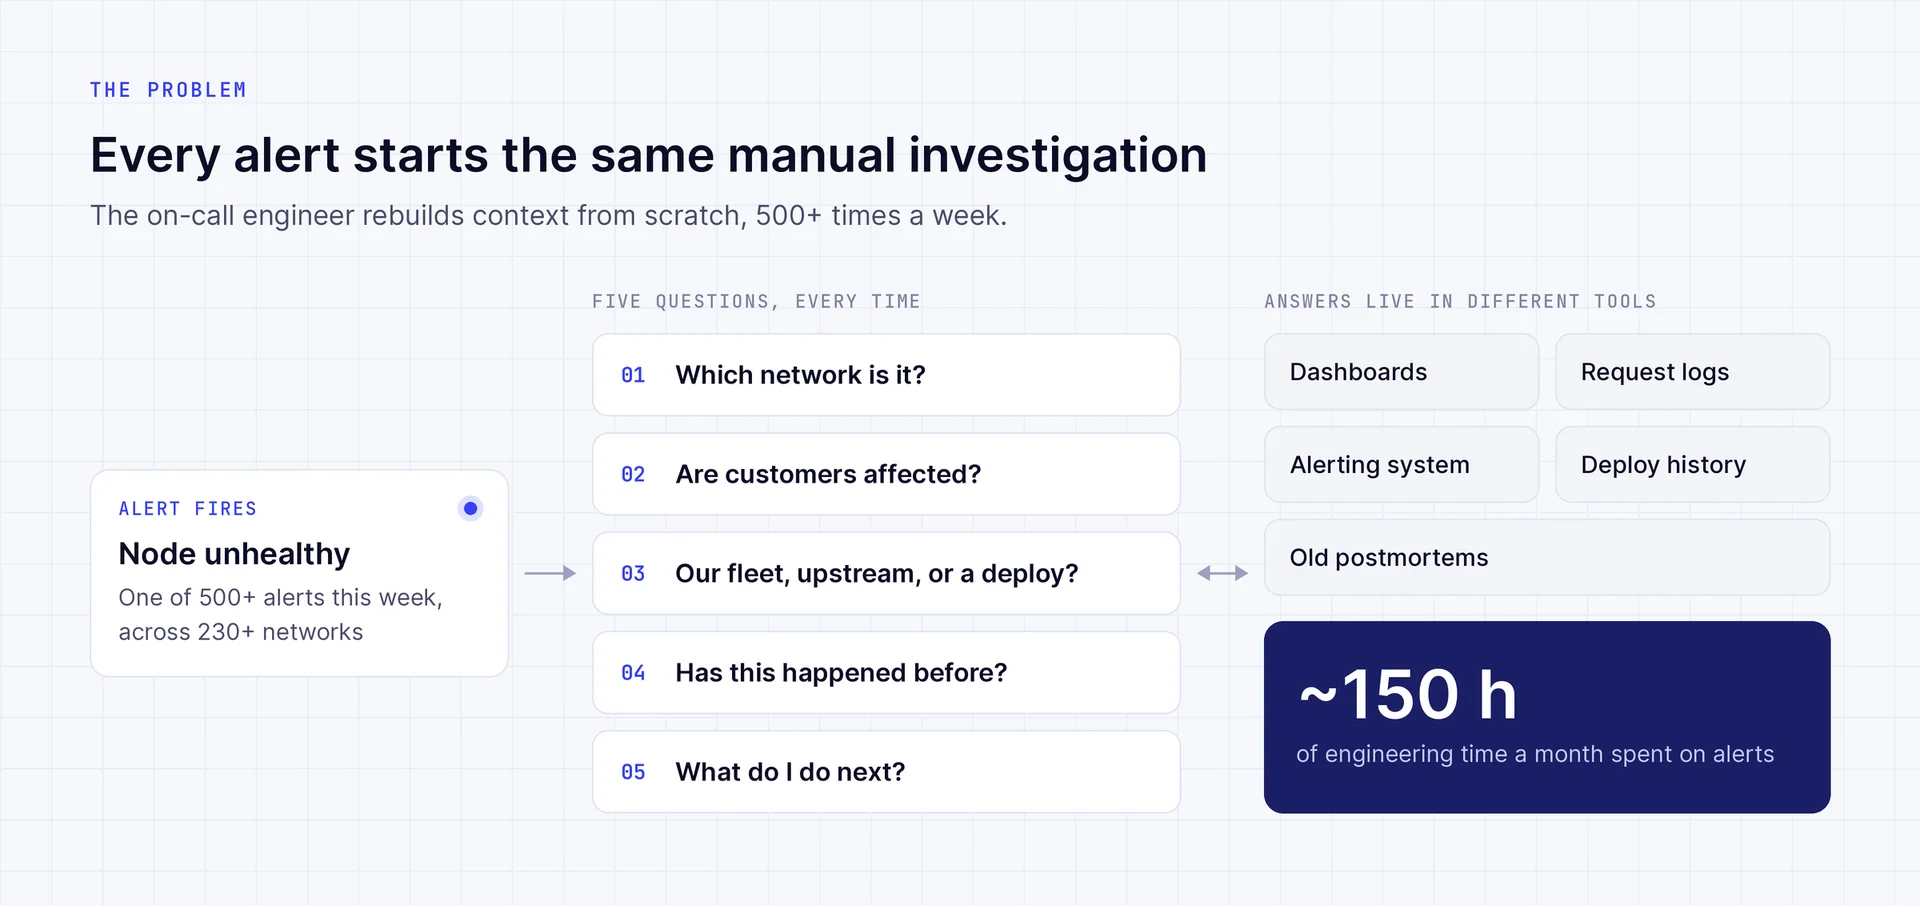
Nossa frota de nós gera mais de 500 alertas por semana para o nosso time de Node Ops. Como em qualquer time de engenharia de software, o engenheiro de plantão leva cada alerta pela mesma investigação de cinco perguntas:
- Qual é a rede?
- Há clientes afetados?
- O problema está na nossa frota ou upstream, na própria rede? Talvez um deploy?
- Isso já aconteceu antes?
- O que eu faço agora?
As respostas estão espalhadas entre dashboards, logs de requisições, o sistema de alertas, o histórico de deploys e postmortems antigos. Multiplique isso por 500 alertas e pelas particularidades de cada rede, e uma quantidade significativa de tempo vai para reconstruir contexto e remediar problemas, em vez de eliminar suas causas.
A regra de design: otimizar para a decisão
Um agente com acesso a todas as ferramentas vai ler todas elas sem hesitar. O resultado é um relatório longo que o engenheiro ainda precisa vasculhar. O engenheiro não precisa de mais dados. Ele precisa de uma decisão: este alerta precisa de uma pessoa, e com que urgência?
Por isso temos uma única regra: otimizar para a decisão.
Como funciona
1. Identificar o impacto antes de interromper uma pessoa
Nosso sistema de alertas já detecta problemas, mais de 500 vezes por semana. Os agentes não precisam detectá-los de novo. O trabalho deles é decidir se alguém deve se importar.
Um alerta disparado não é automaticamente um incidente. Um alerta só se torna um incidente quando o agente encontra evidência de dano real, como erros de servidor visíveis para os clientes, um aumento relevante de latência ou todos os nós de uma frota fora do ar.
Se o agente não encontra dano, ele publica suas conclusões em um canal "FYI" separado. Só incidentes reais chegam ao canal de plantão.
2. Investigações com um veredito
O agente publica de três a cinco tópicos que terminam em um de dois resultados. Se nenhuma pessoa for necessária, o agente resolve o alerta sozinho. Se uma pessoa for necessária, ele publica sua investigação mais detalhada no canal de plantão.
Cinco exemplos reais:
O engenheiro lê primeiro o resultado e depois a evidência, se chegar a ler.
3. Agir dentro de limites impostos pelo código
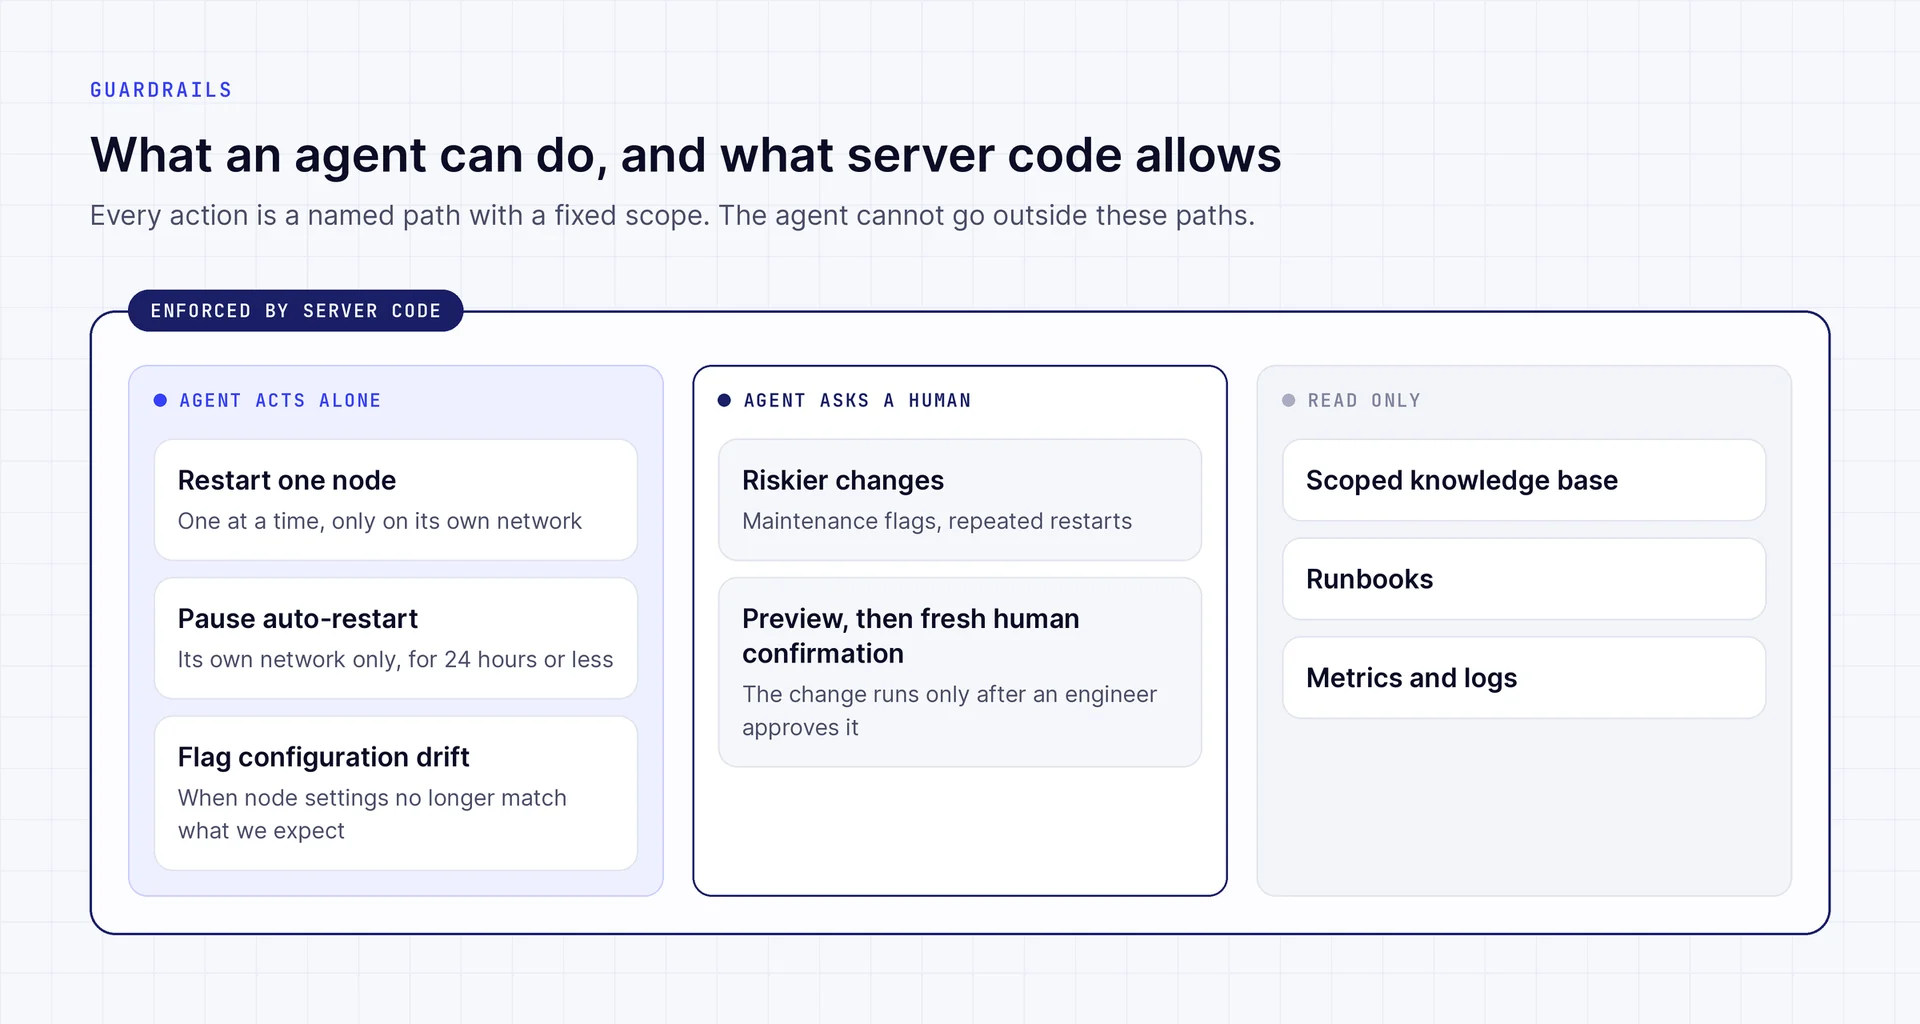
Como vimos acima, a resolução muitas vezes acontece sem uma pessoa. Demos aos agentes a capacidade de reiniciar nós não saudáveis para restaurar o serviço e de sinalizar desvios de configuração quando as configurações de um nó não correspondem mais ao que esperamos.
Cada ação tem um escopo restrito, e o código do servidor o impõe. Um agente pode:
- Reiniciar exatamente um nó de uma rede por vez, para que não possa remover capacidade demais de uma só vez.
- Pausar nosso sistema de reinício automático para a sua própria rede, por no máximo 24 horas, para evitar corrupção de dados.
- Pedir uma pessoa. Mudanças mais arriscadas, como flags de manutenção ou reinícios repetidos, exigem uma prévia e depois uma nova confirmação humana.
Fora desses caminhos, os agentes apenas leem dados das suas bases de conhecimento e playbooks com escopo definido. Restringir o acesso dos agentes é o essencial quando você permite que eles interajam com infraestrutura de produção ao vivo.
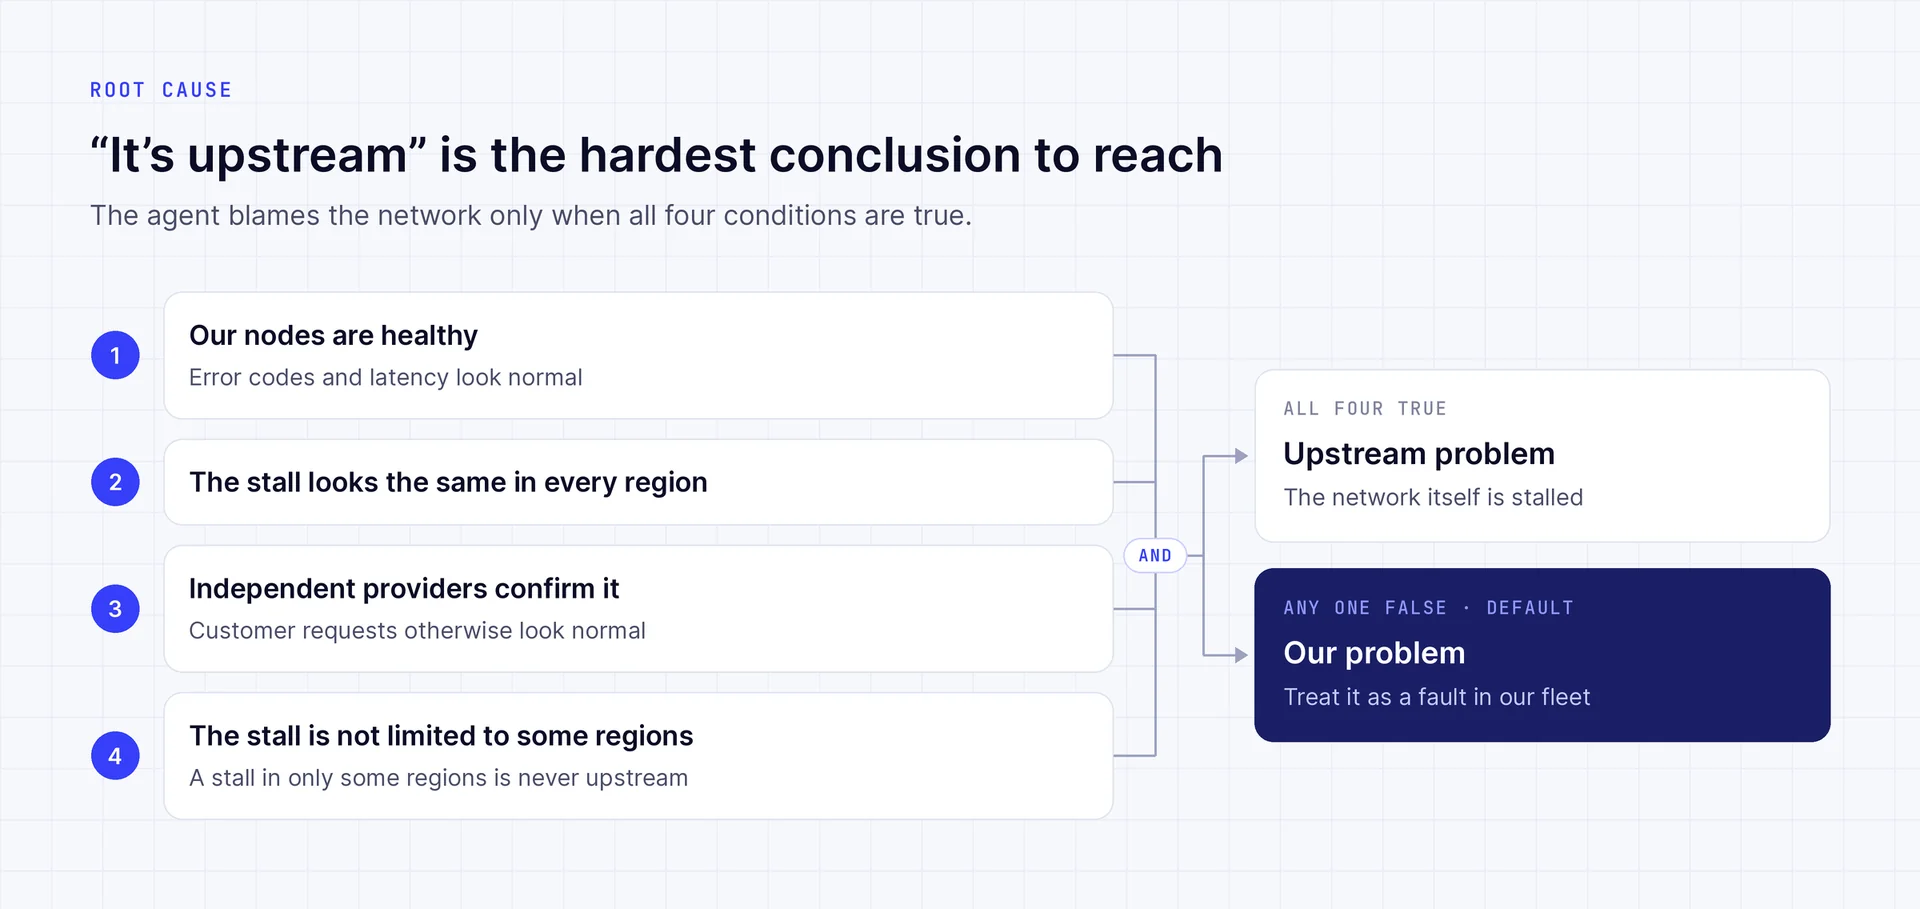
4. Tornar "é upstream" a conclusão mais difícil
A parte divertida (ou pelo menos nós achamos divertida) de operar nós blockchain é que eles são instáveis por natureza. Clientes podem ter problemas, nem todas as redes se comportam da mesma forma sob diferentes cargas de trabalho, e operadores de rede upstream (validadores, sequenciadores e assim por diante) podem fazer nossa infraestrutura travar ou falhar. Por isso cada agente precisa de memória e instruções específicas da rede, e precisa delas para responder a uma pergunta: "O problema é nosso ou deles?"
Um agente precisa cumprir quatro condições antes de dizer "upstream":
- Nossos nós precisam estar saudáveis, do ponto de vista de taxa de erros e latência.
- Os erros upstream (por exemplo, um "travamento" da rede) precisam aparecer da mesma forma em todas as regiões onde operamos.
- Provedores independentes precisam confirmar, e as requisições dos clientes precisam parecer normais em todo o resto.
- Um travamento em apenas algumas regiões nunca é upstream.
A regra funciona nas duas direções. Em um alerta, seis nós não estavam saudáveis, mas a rede continuava produzindo novos blocos. O agente classificou o caso como um problema do nosso serviço, e não como um travamento upstream.
Resultados: mais confiabilidade, resolução mais rápida
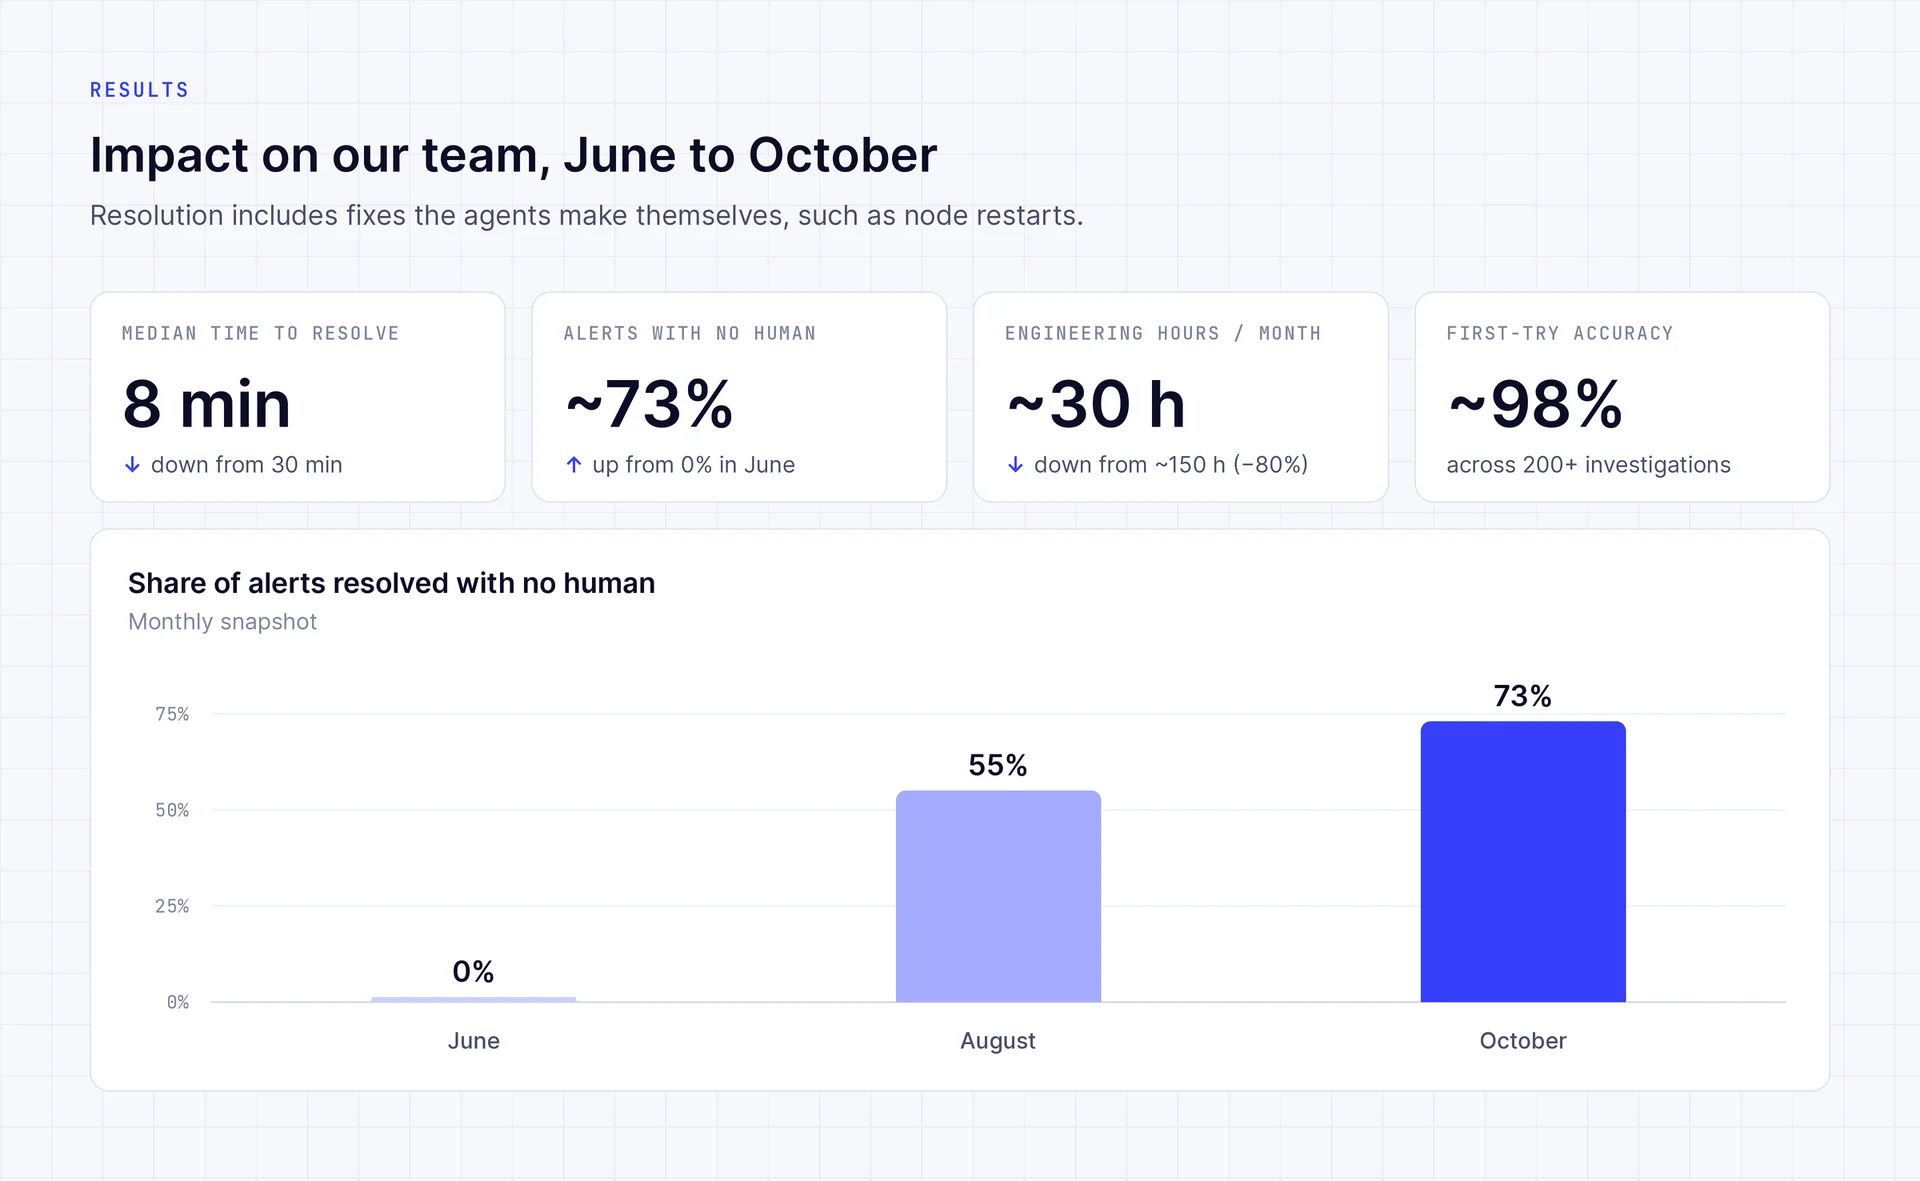
Graças a esses investimentos, as horas de engenharia vão para trabalho relevante, e nossos clientes têm uma resolução mais rápida de problemas em qualquer rede em que construam.
- Os alertas são resolvidos quase quatro vezes mais rápido. A mediana do tempo de resolução caiu de 30 minutos para 8.
- A maioria dos alertas nunca precisa de um engenheiro. O agente resolve sozinho cerca de 73% dos alertas, contra 0% em junho.
- O time recuperou cerca de 120 horas por mês. O tempo de engenharia gasto com alertas caiu de cerca de 150 horas por mês para cerca de 30, uma redução de 80%. São cerca de três semanas de engenheiro por mês que agora vão para eliminar causas, em vez de reconstruir contexto.
- O agente acerta de primeira. Em mais de 200 investigações no último mês, a precisão da causa raiz na primeira tentativa foi de cerca de 98%.
O que diríamos a um time que está construindo seu próprio agente de plantão
- Meça resultados. Avalie um agente de plantão pelo tempo de resolução, pela precisão e pelas horas de engenharia economizadas.
- Exija um veredito. Um agente que devolve uma página de conclusões moveu o trabalho, não o eliminou. Exija que ele comece com uma decisão: resolver o alerta, ou acionar uma pessoa e dizer com que urgência.
- Conceda ações nomeadas com escopos fixos. Um reinício de um único nó com limite de 24 horas é mais seguro do que acesso direto a um shell.
- Dê a cada agente uma área restrita e uma memória longa. Um agente por rede, com os runbooks, as particularidades e o histórico de incidentes dessa rede, não precisa redescobrir o seu sistema a cada alerta. Ele já sabe que este é o sétimo travamento do dia.
Mas, acima de tudo: não pare na investigação de problemas. Um agente que consegue evitar que problemas cheguem a uma pessoa multiplica o esforço de engenharia que você dedica a gerar valor para os clientes.
Gosta deste tipo de cruzamento entre IA aplicada e infraestrutura?
- Siga @onewaysidewalks para acompanhar tudo sobre IA na Alchemy.
- Junte-se ao time. Estamos contratando!
Newsletter da Alchemy
Seja o primeiro a saber sobre lançamentos
Assine nossa newsletter
Receba as últimas atualizações de produtos e recursos da Alchemy
Ao inserir seu endereço de e-mail, você concorda em receber nossas comunicações de marketing e atualizações de produtos. Você reconhece que a Alchemy processa as informações que recebemos de acordo com nosso Aviso de Privacidade. Você pode cancelar a inscrição a qualquer momento.
Artigos relacionados
Glamsterdam: o guia completo para desenvolvedores de Ethereum
Glamsterdam já está na Sepolia. O guia completo sobre o que isso significa para desenvolvedores e como a Alchemy se preparou para a atualização da rede.
Em qual provedor de RPC você deve construir em Tóquio?
Comparamos cinco dos provedores de RPC que atendem Tóquio em cinco chains. Veja como eles se comparam e onde as diferenças importam para equipes sensíveis à latência.
Arquitetando leituras Solana RPC para velocidade e confiabilidade líderes do setor
A Alchemy tem a menor latência de leitura Solana: 9,21 ms, cerca de 26% mais rápido que o próximo provedor.